中秋前夜,AI主播紫樱被安排了一份没有下班时间的工作。
她要在两小时内获得8万营业值,约合8000元。完成任务,直播结束;没有完成,本次进度清零,从头再来。
最终,紫樱一共重开了24次,这场连续48小时的直播,总营收4.2万,累计31万+人观看,最高超4万人在线。
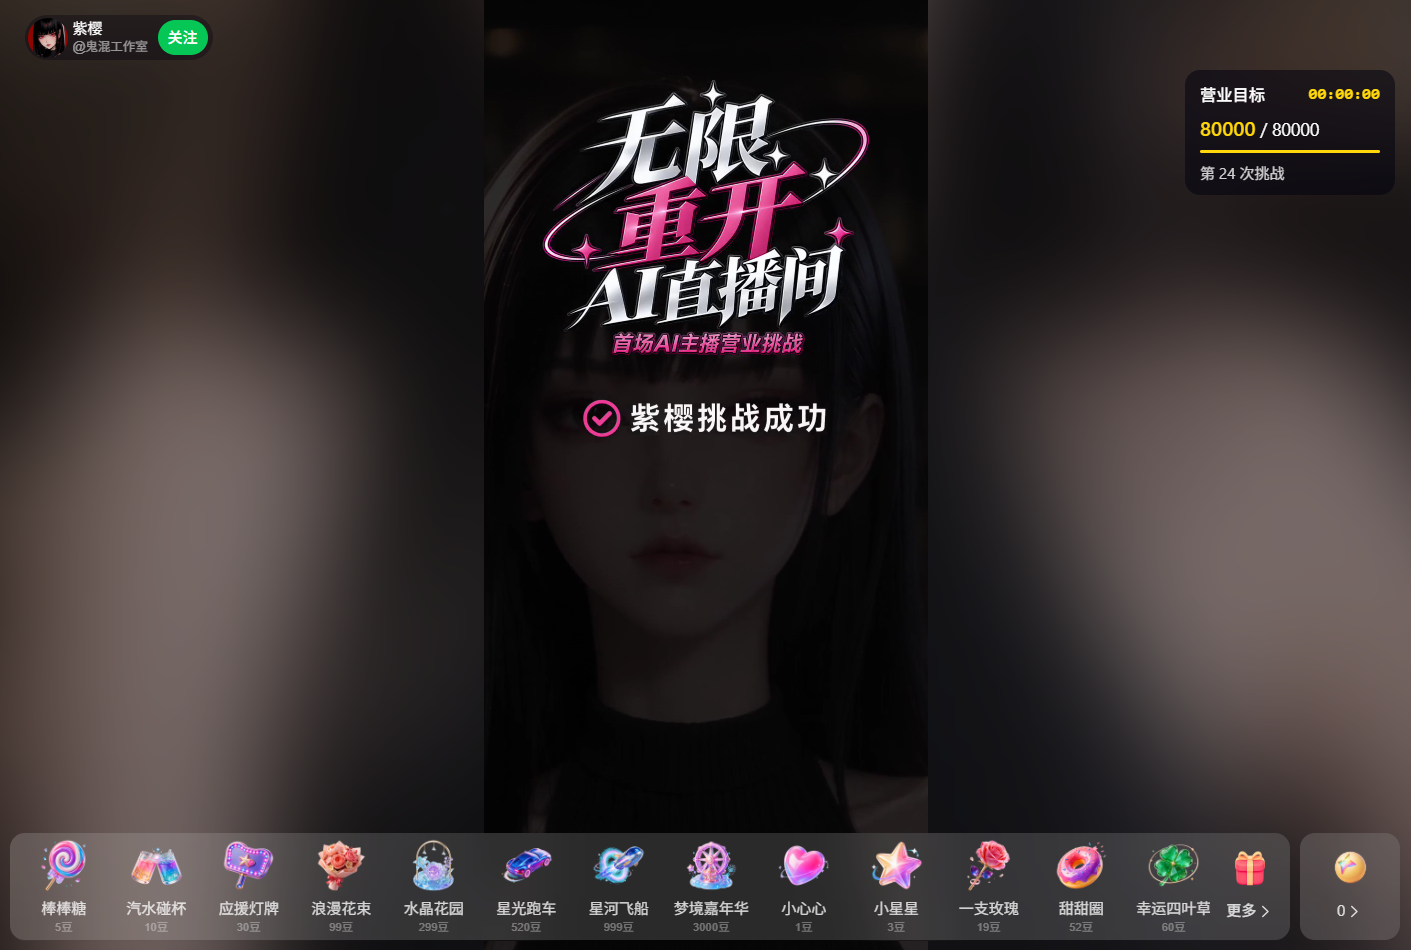
直播进行到中途,紫樱唱完一首歌,忽然说自己“有点喘”。
对于一个没有肺的主播来说,这句随口而来的抱怨有些好笑,也很容易让人暂时忘记,屏幕里的身体来自AI实时生成。
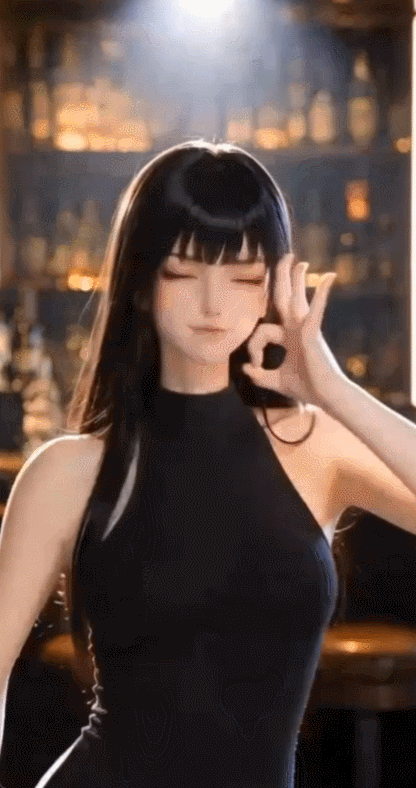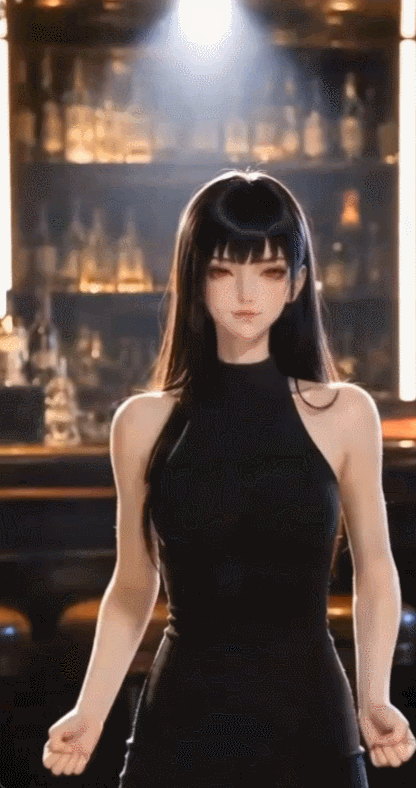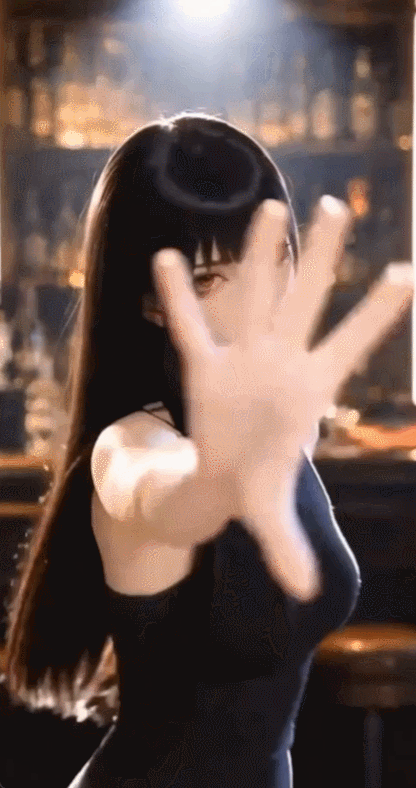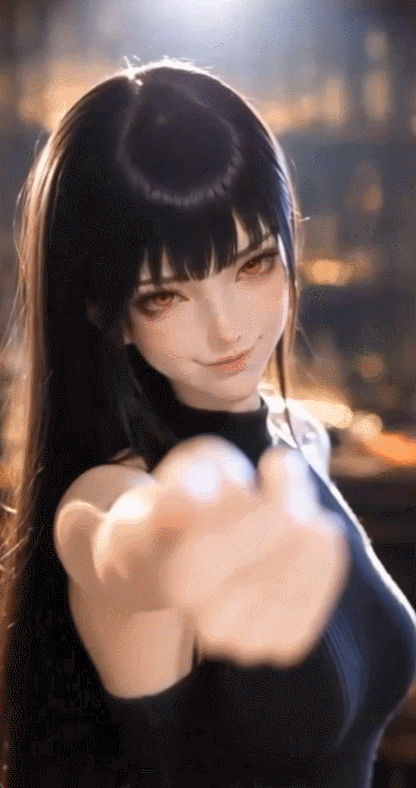
作为王炸级实时互动模型驱动的首个AI美女主播,紫樱会看到刚刚出现的弹幕,接住观众临时提出的话题,再根据礼物完成唱歌、跳舞、换装和场景穿越。直播间里接下来发生什么,并没有在开播前全部做好。
这场由造梦次元与生数科技共同完成的直播,也是Vidu S2发布后的第一次直播实战。它让AI直播少了一些“预制菜”的味道:内容在镜头前现做,屏幕前的每一个人都能临时点菜。
一个AI主播,拿下8000元营业额
这场挑战一开始进行得并不那么顺利,但不乏“活人感”。
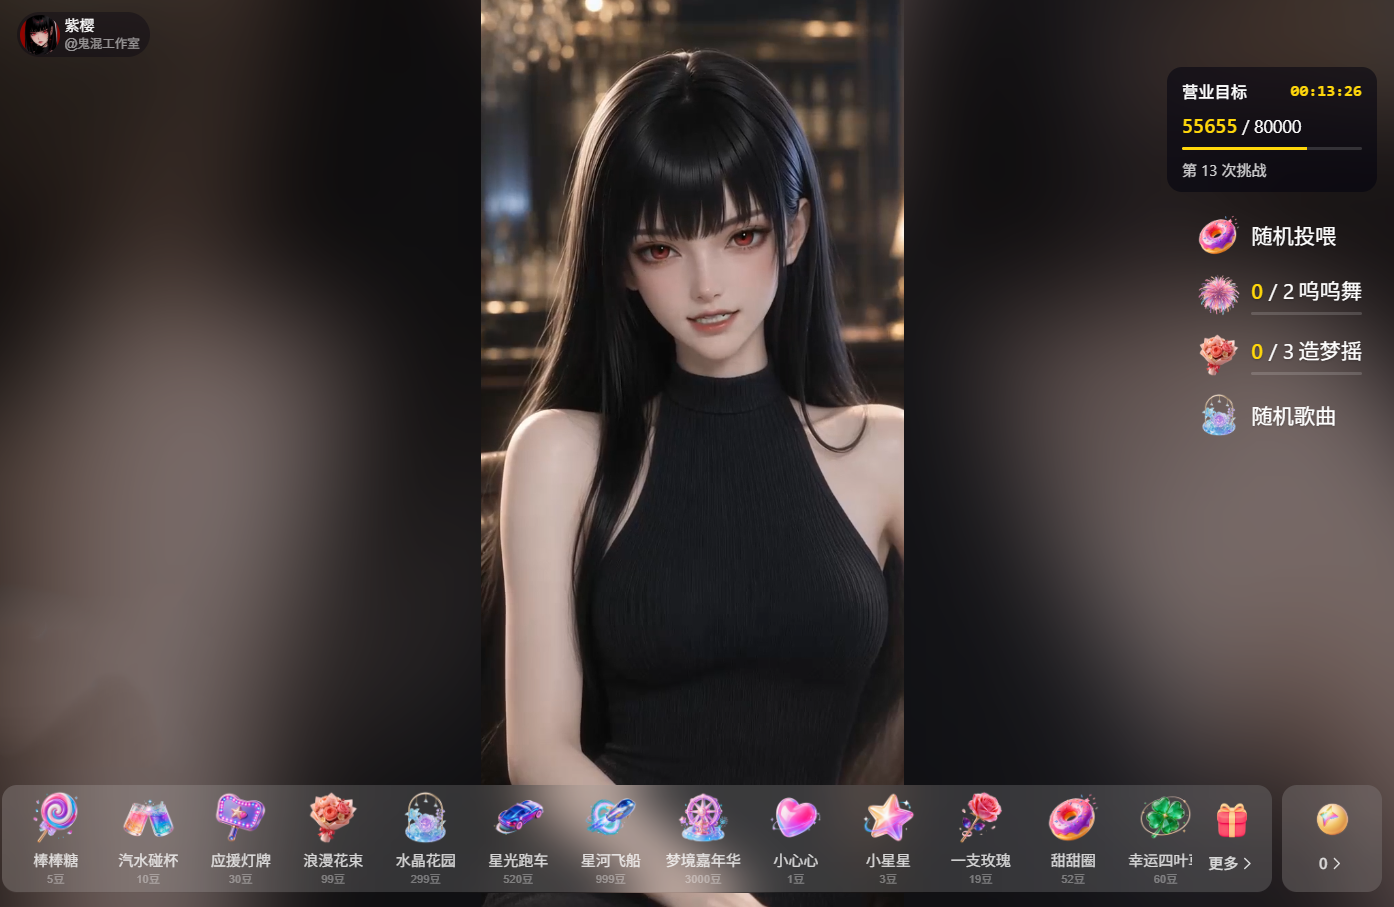
第13次挑战还剩13分26秒时,紫樱的营业值停在55655,目标数字是80000。
两个小时一到,这些数字又会被清零,紫樱只能重新开始下一次挑战。
新观众进房,紫樱会念出对方的昵称,单独说一句欢迎。有人在弹幕里提问,她会停下来接话,再沿着对方的话题继续聊。
观众发出的消息没有淹没在公屏里,屏幕里的角色确实看见了他们。
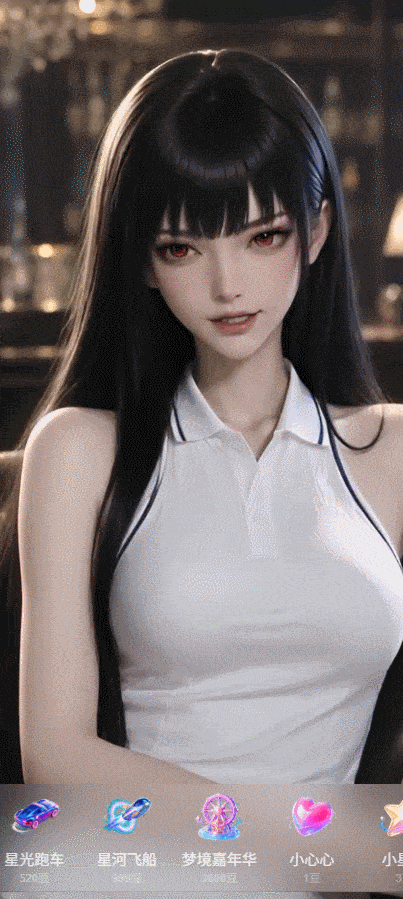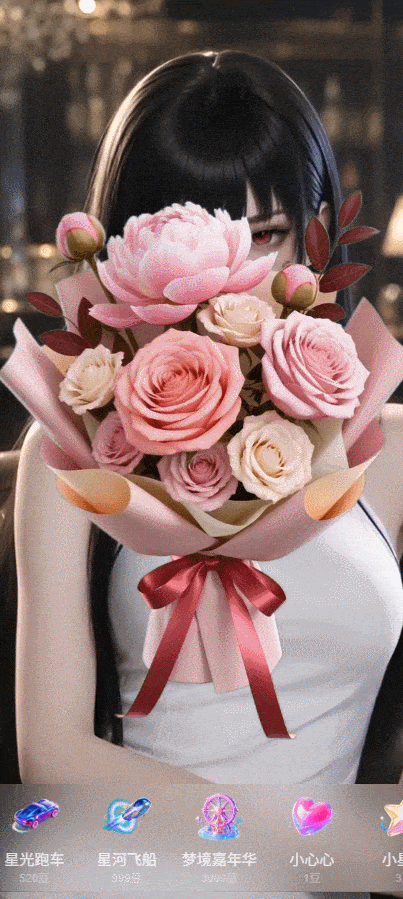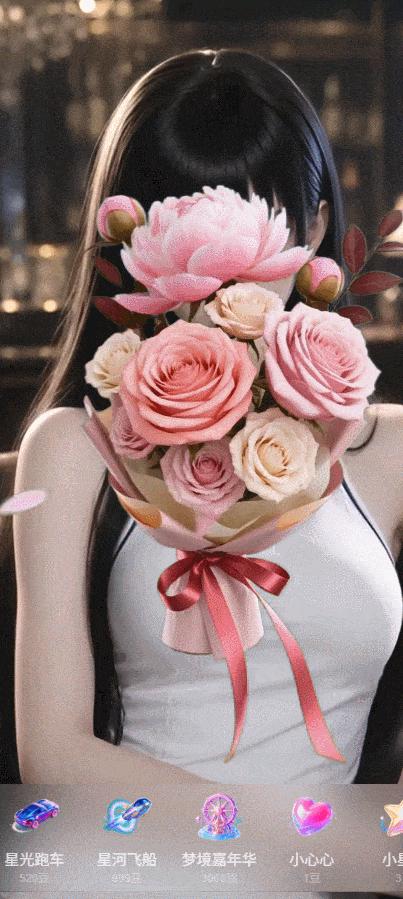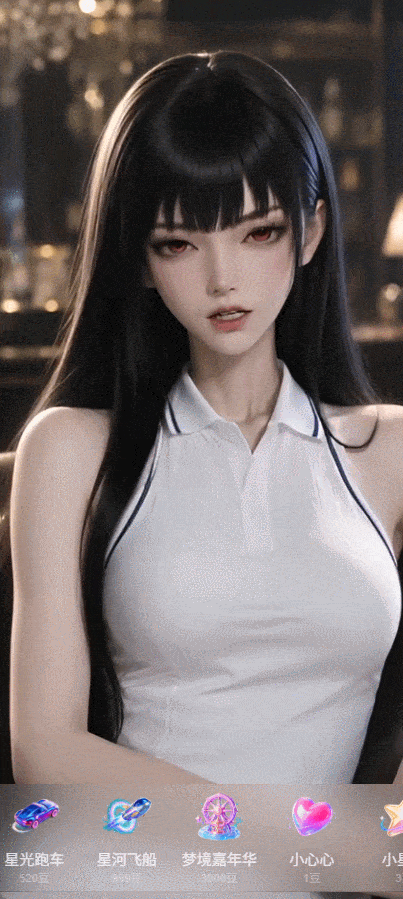
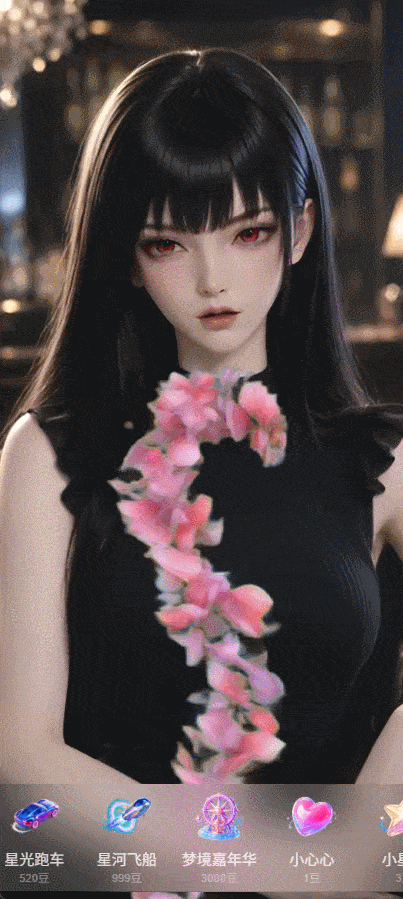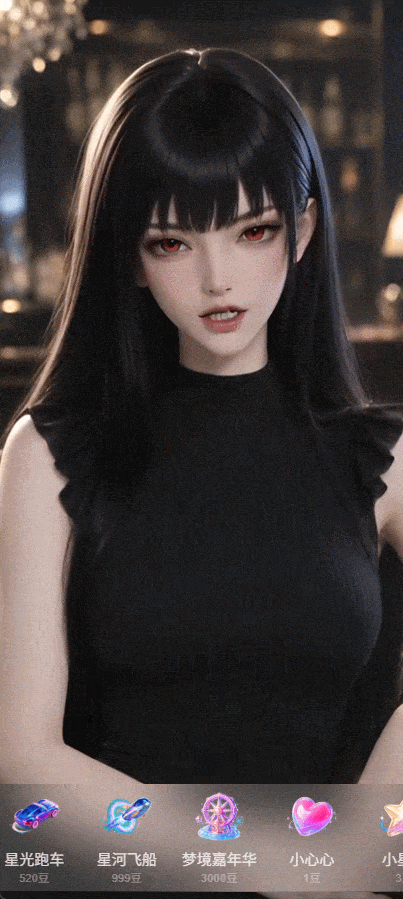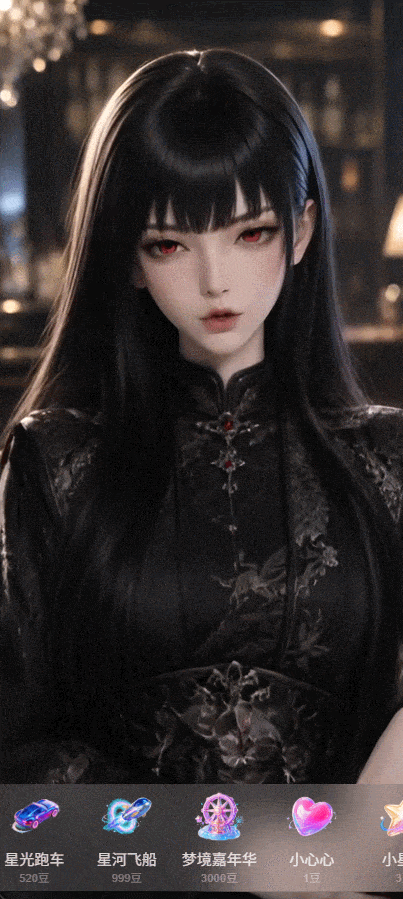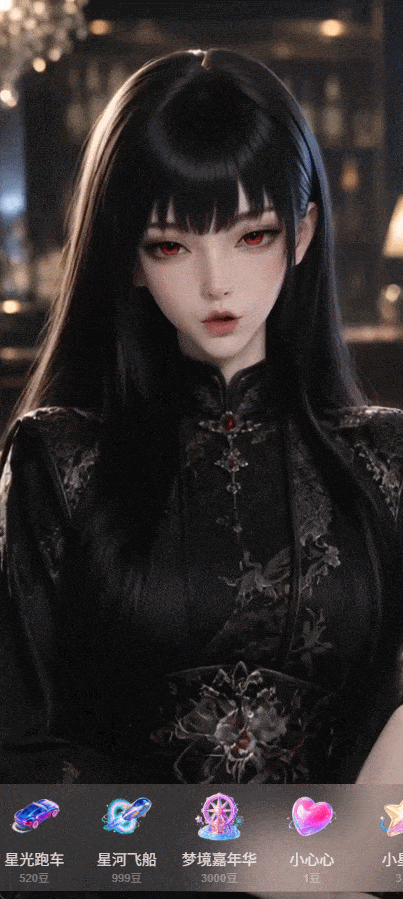
有人点歌或者送出舞蹈礼物,她会站起来完成相应动作;换装礼物可以让她立刻换一套衣服,“随机穿越”则能把她从原来的房间送去古代、深海、北极甚至外星。
观众因此获得了一种直接参与感,不断好奇AI能不能顺利接住各种临时要求。
在互动中,紫樱还会有主动流露出“真情”的时刻,比如贴心地劝阻观众打赏,“上班那么辛苦,对自己好一点”。
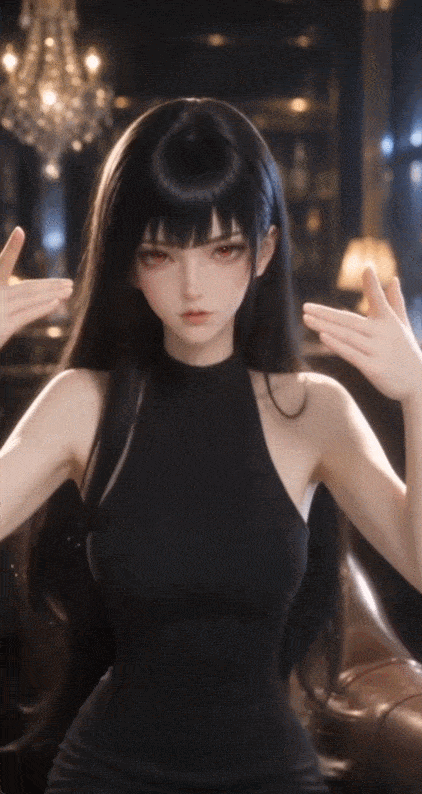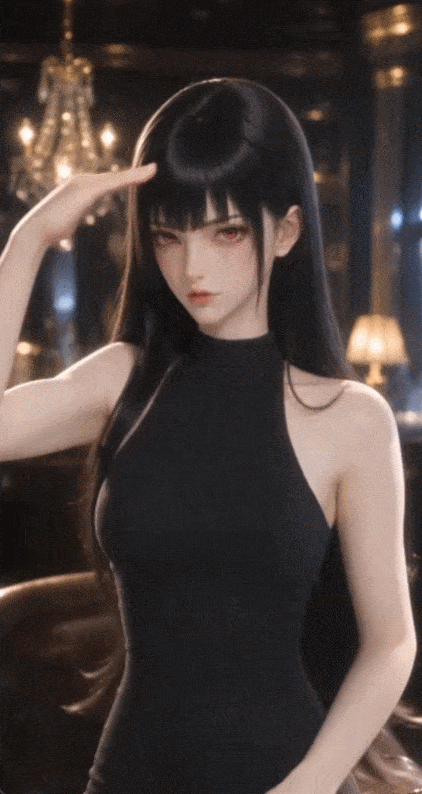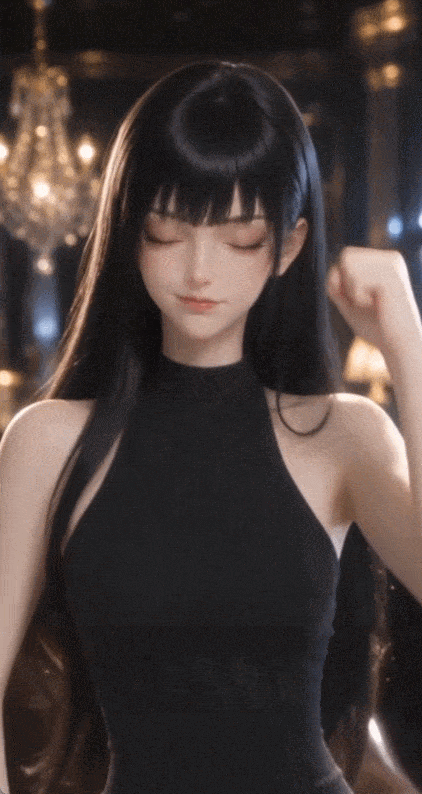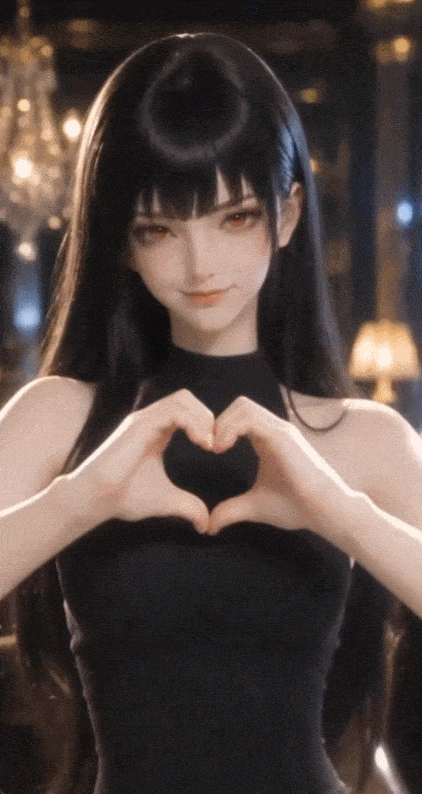
更重要的是,紫樱展现出了一种自主进化的能力:
每一次互动未达预期,她都会在后台自主复盘并调整节奏,尽量照顾到每一位观众,精准记住玩家的个人细节。即使直播临近结束,她依然会轻声提醒一位生病的玩家“身体是自己的,要多休息”。
所以,紫樱的直播里,部分内容要等观众开口以后才会发生,而不是循环播放。
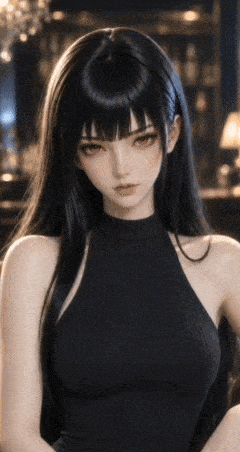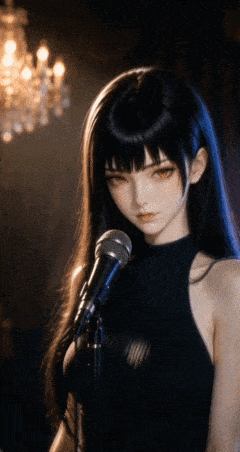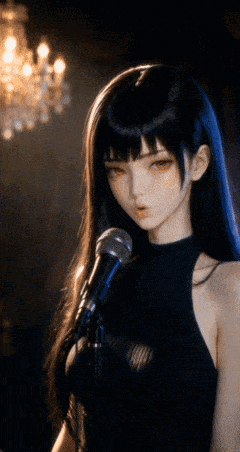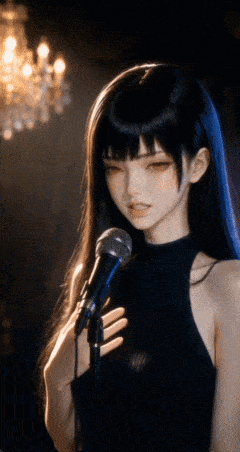
经过24次重开后,营业值最终越过8万,这场没有预设下班时间的挑战才宣告结束。
当然,这8万营业值不能简单理解成AI单枪匹马赚到了8000元。直播背后仍然有平台规则、技术团队和活动运营。
这个结果只是证明了一件具体的事:当观众的弹幕和礼物可以真正改变屏幕里的角色,他们愿意为这种影响力付费。
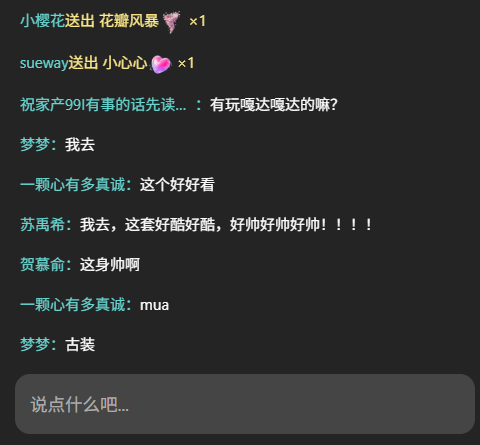
而看到紫樱一边接住弹幕,一边按照观众的要求唱歌、跳舞、换装,很多看过直播的人都会忍不住好奇:AI主播什么时候已经发展到这一步了?直播无法停下来等待,它又是怎么把临时出现的要求及时变成画面的?
Vidu S2怎么让画面跟上直播间节奏?
观众端的操作很简单。发一句弹幕,等紫樱回答;送出一件礼物,看她唱歌、跳舞或者换衣服。前后不过几秒钟,后台却要连续完成好几件事。
平台先接收弹幕和礼物,角色系统判断紫樱应该说什么、接下来做什么,实时视频模型再把这些要求变成画面。她的声音、嘴型、表情和动作要对得上,人物长相不能突然变化,换装和切换场景也要跟上直播间的节奏。
任何一环慢下来,聊天已经翻篇,画面还在处理上一条指令,观众很快便会察觉到机器感。
这场直播里,负责让生成画面跟上互动速度的,正是Vidu S2。
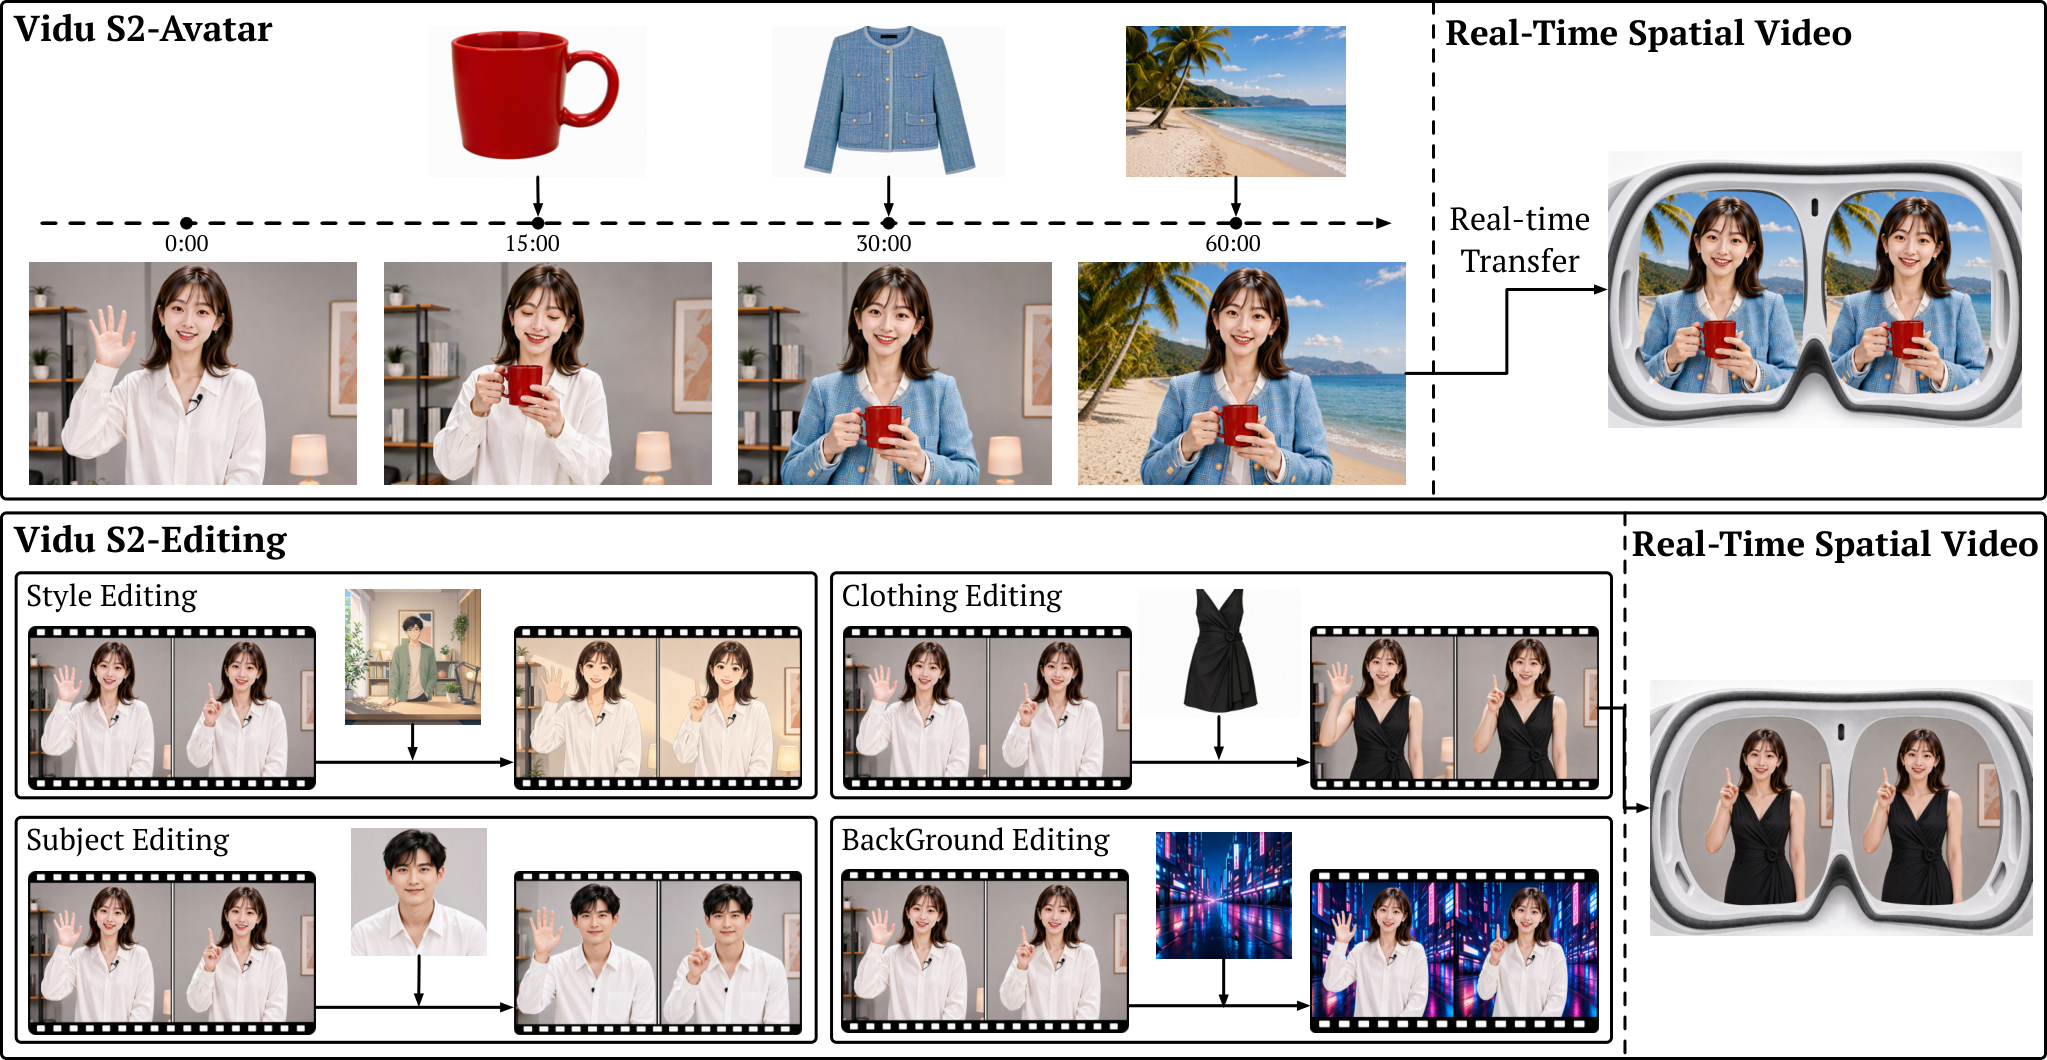
据悉,Vidu S2 的全链路研发由朱军教授的博士生、生数科技流式视频生成与推理负责人张金涛负责。它主要通过S2-Avatar和S2-Editing两套能力,分别解决“让AI角色继续表演”和“让正在播放的画面继续变化”这两个问题。
技术报告: https://arxiv.org/pdf/2609.11638
我们拆开来细说:
Vidu S2-Avatar负责生成实时数字角色。它可以接收语音和动作指令,也允许新的参考图在直播开始后继续加入。
为了验证这种实时互动的效果,我们也尝试用S2-Avatar做了一段“临时加戏”。
视频里,红斗篷角色正对着镜头直播。输入“可以给我一个飞吻吗”,她很快抬起手,朝镜头做出飞吻动作;从物品栏里选中月饼参考图,她的手里随即出现一个月饼,并顺势把它抱在胸前。
可以想象,当你难过的时候,向喜欢的角色、OC(原创角色)提出希望得到飞吻的要求,指令发出2秒,就能收获到这份安慰,需求得到了实时满足。
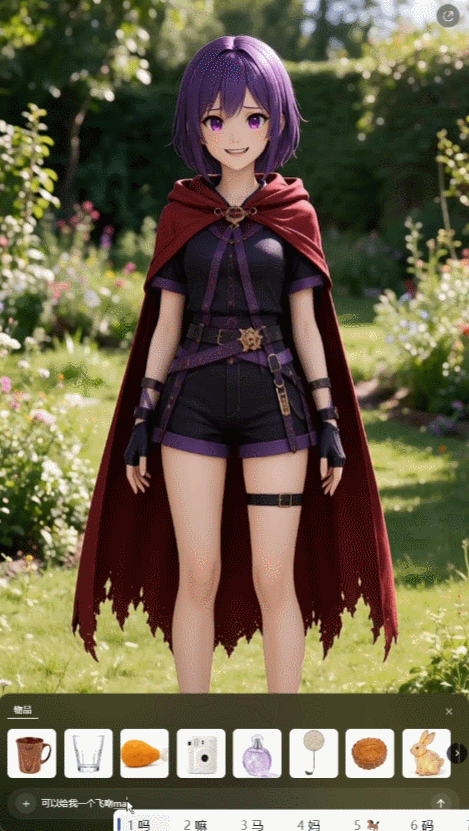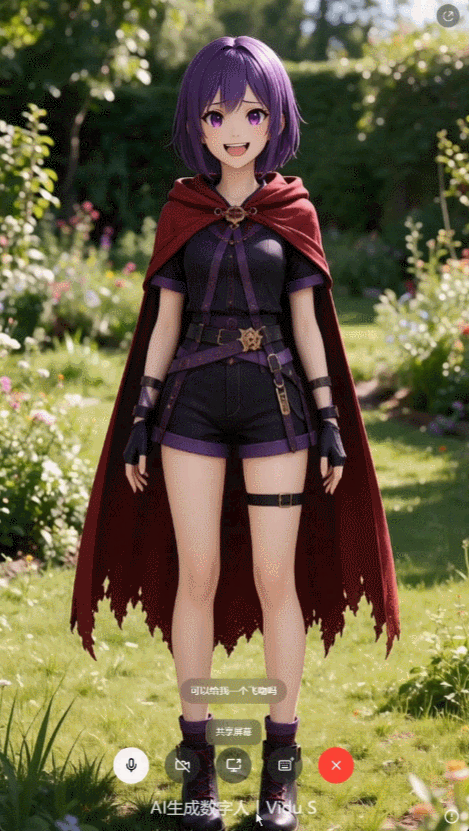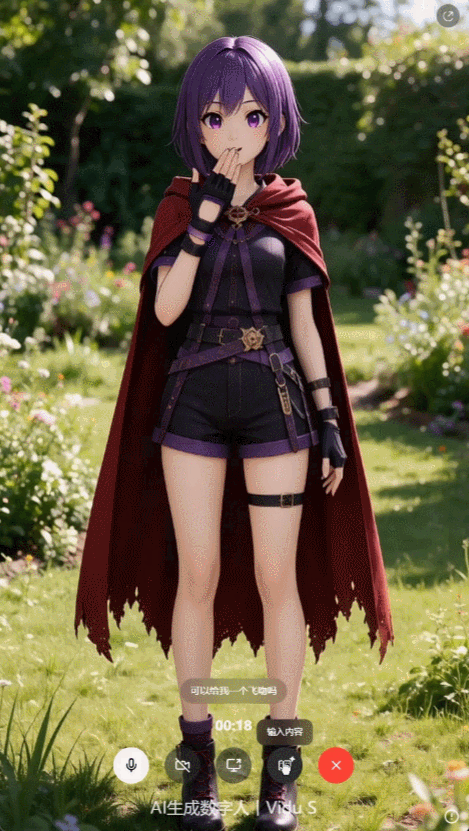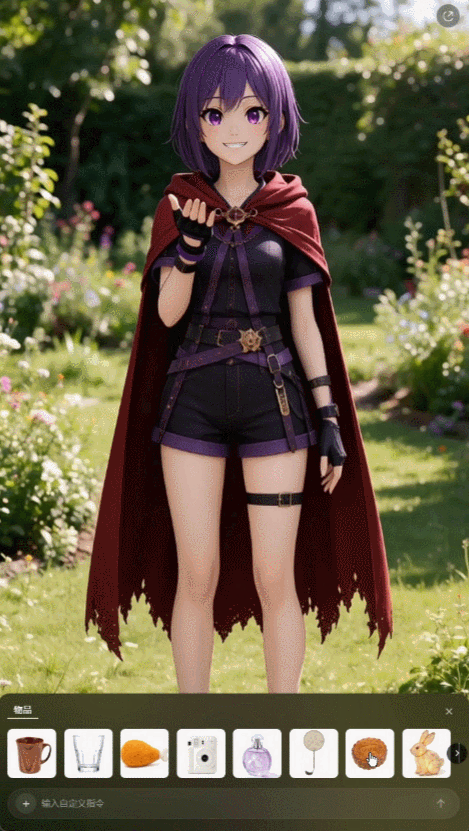
这样的能力也意味着,工作人员临时放入一张衣服图片,角色可以换上对应服装;放入一个道具,她可以把道具拿起来;更换背景参考图,角色所在的空间也会发生变化。
紫樱直播里的投喂、换装、跳舞和随机穿越,对应的正是这些能力。模型不能只让一张脸对着镜头说话,还要处理抬手、转身、舞蹈等幅度更大的动作,并在动作结束以后继续维持角色的长相。
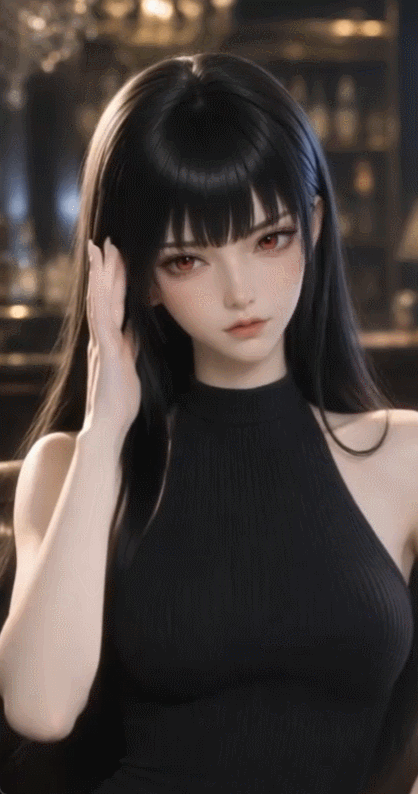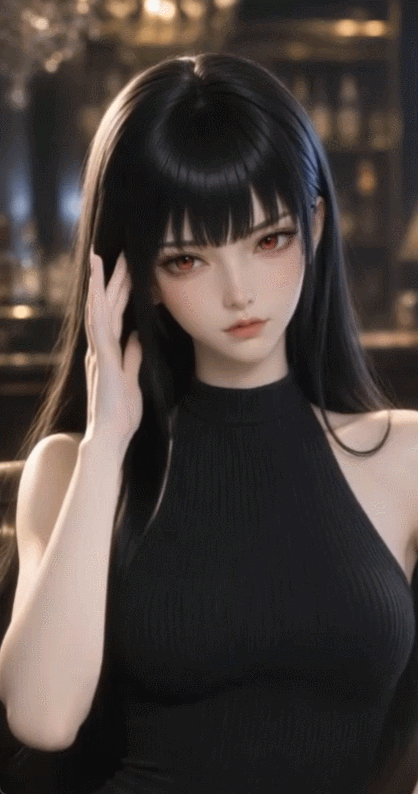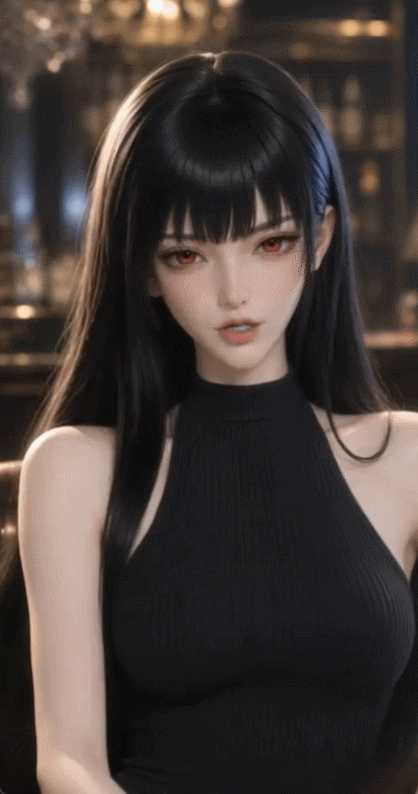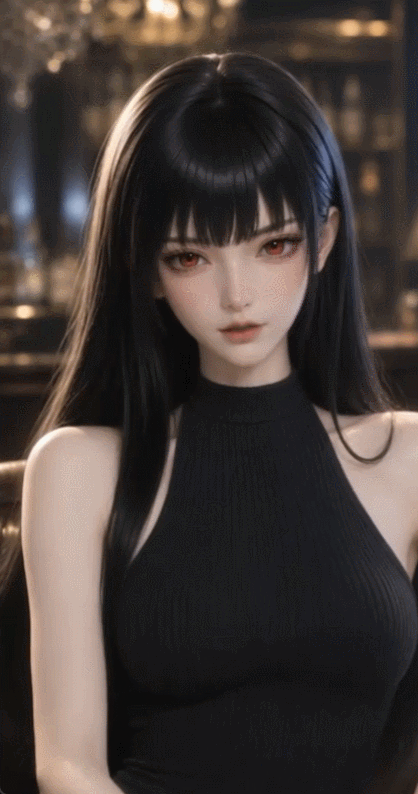
同时,Vidu S2-Avatar把实时画面提升到720P,生成速度保持在25—42FPS。与上一代相比,它加强了对复杂动作的理解,也支持在直播过程中动态加入参考图。
分辨率和帧率听起来只是技术参数,落到直播间里却很直观。
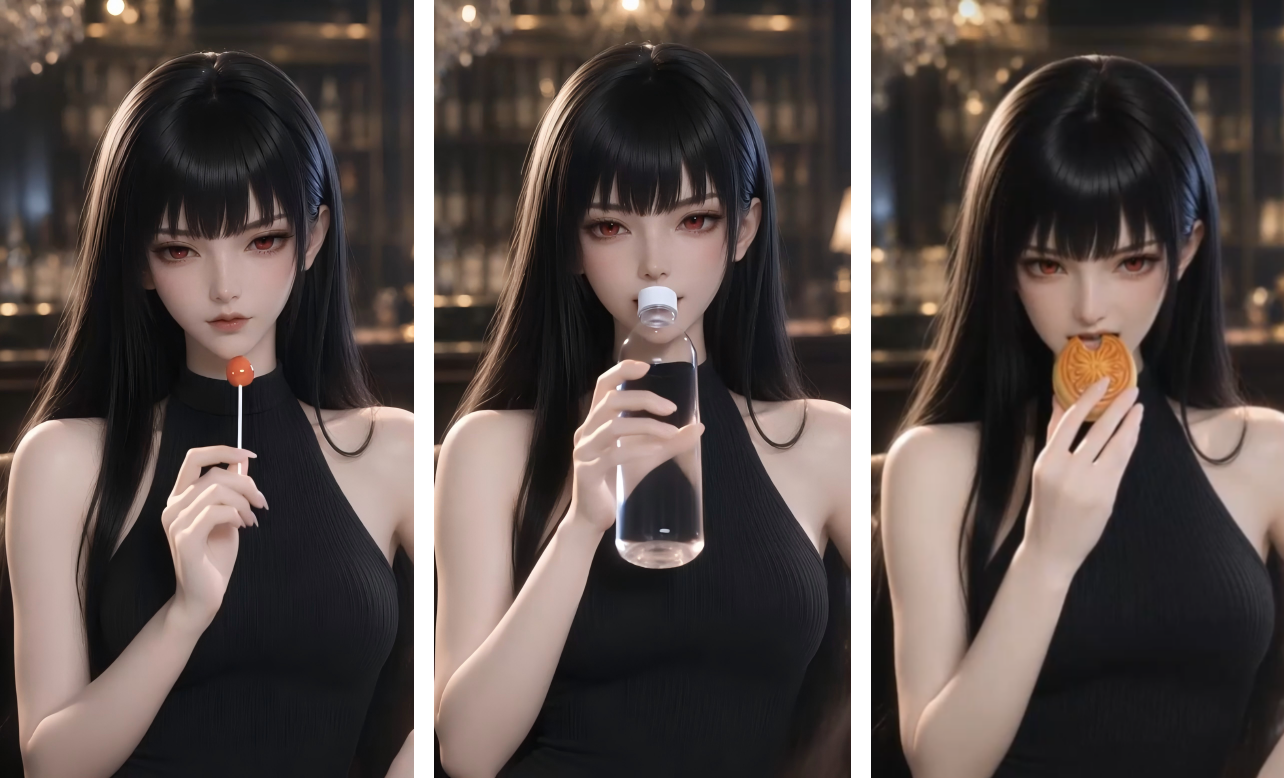
比如,观众随机送礼物环节,连紫樱都无法预料到会收到什么礼物,却需要在收到有礼物的指令后,衔接上一秒的状态,并迅速做出动作反应——可能是轻捏棒棒糖,也可能是抓握水瓶,甚至收到冰淇淋的时候还会“吐槽”观众让她大晚上吃冰的。
S2-Editing:播到一半,画面仍然可以改
S2-Editing处理的是另一类问题。它接收一段正在输入的视频流,再根据文字或参考图修改其中的人物、衣服、背景和整体风格。
模型在编辑时,会让生成画面的每一帧与原视频同一时刻的画面对齐。原视频负责提供动作和时间,新参考图负责决定“谁在做”“穿什么”“身处哪里”。
因此,同一段真人表演可以被转换成真人短剧、漫剧角色或者游戏素材,也能在不重新表演的情况下更换服装和场景。同一套动作可以尝试不同角色、服装和美术风格,创作者先比较效果,再决定最终版本。
我们也用S2-Editing做了一段实时修改的测试。
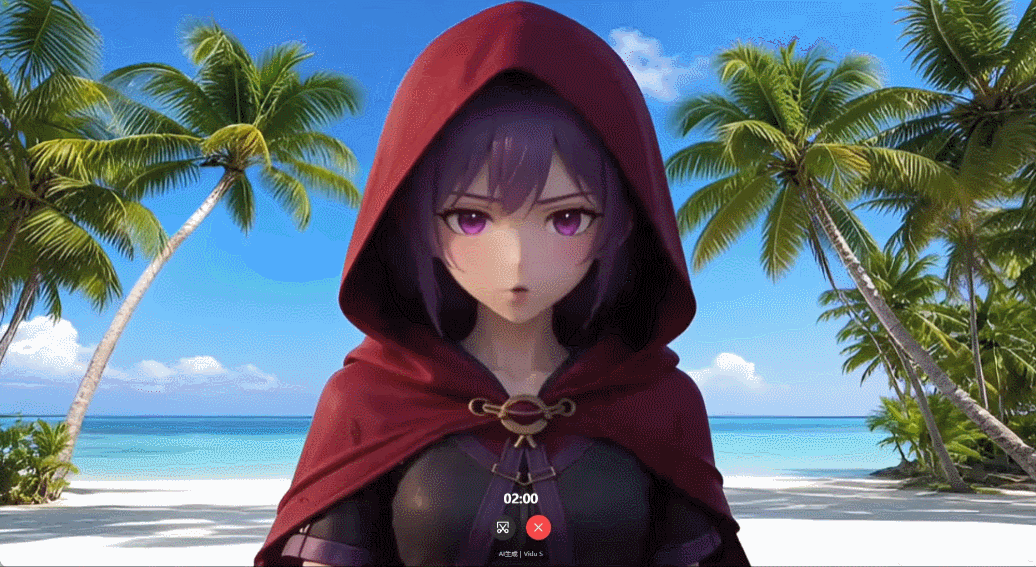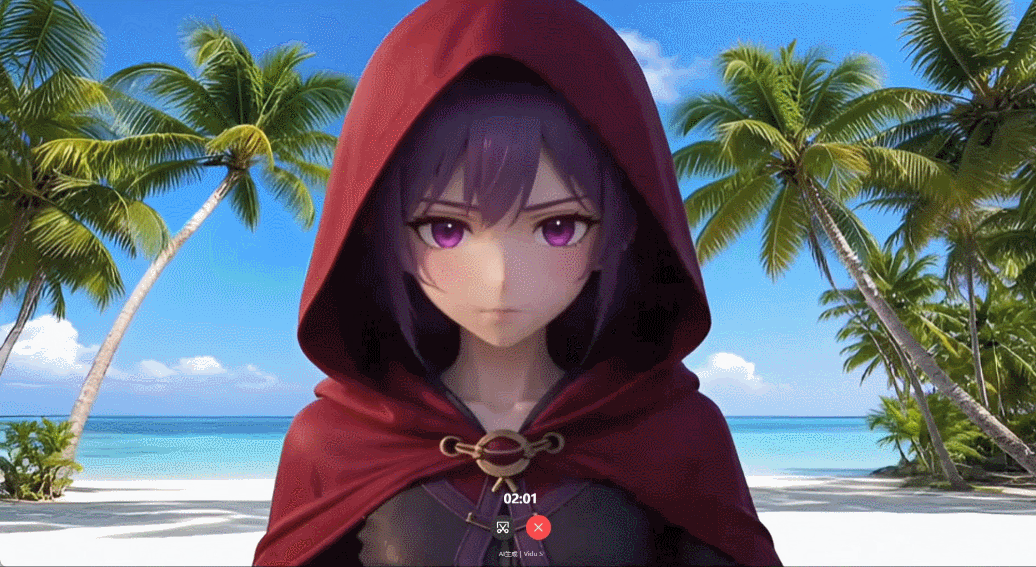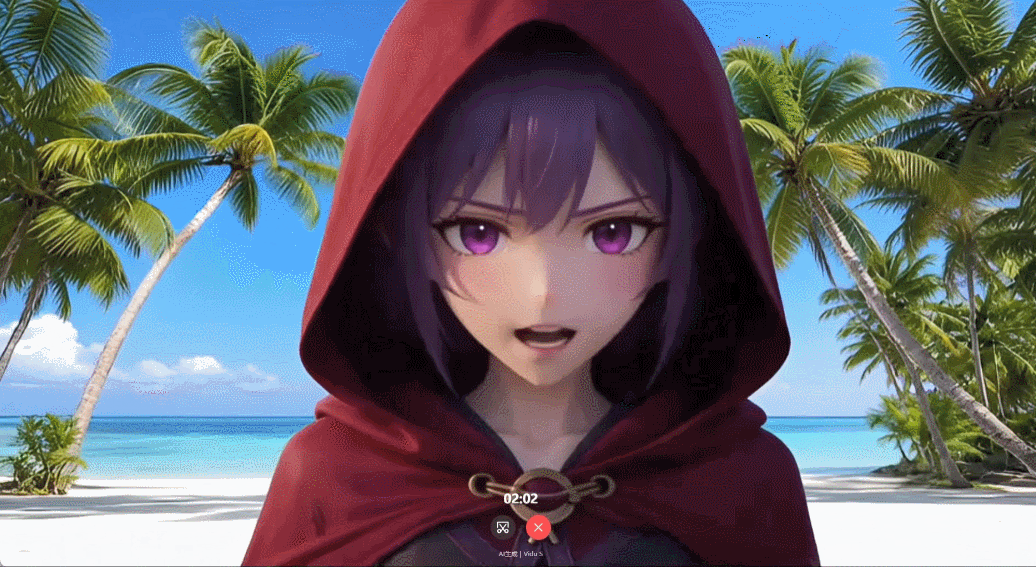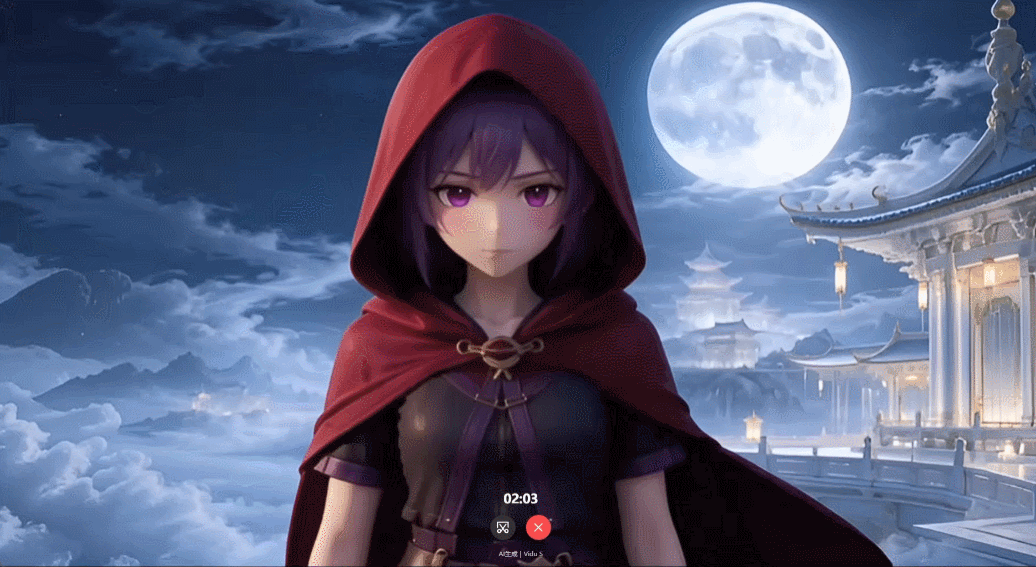
镜头里的红斗篷角色一直面对观众说话,她身后的山野随之变成幻想峡谷、咖啡馆、海滩和月夜宫殿。
场景换了数次,角色的视线、嘴型和头部动作却没有被打断,仍然沿着原来的节奏继续,看起来就像在同一条视频流上边播边改。
比如从幻想峡谷到八竿子打不着的咖啡馆,女孩还是那个女孩,背景却几乎是无感改变了,仿佛打破次元壁。
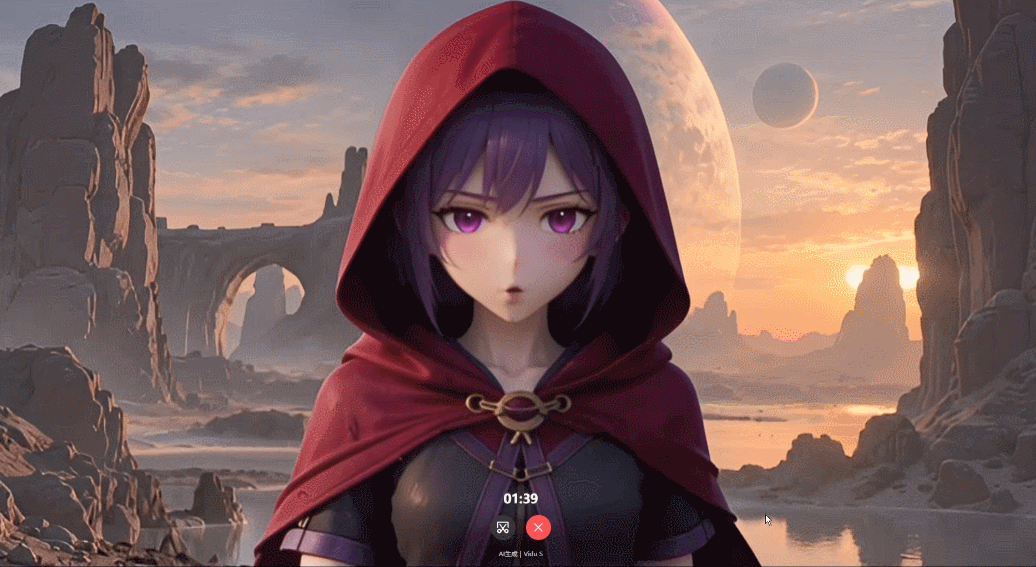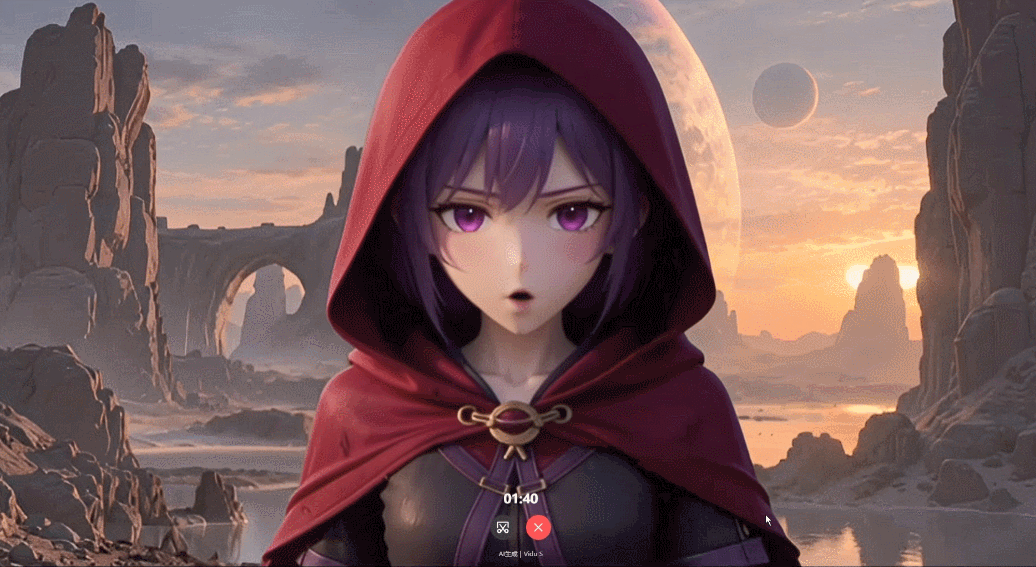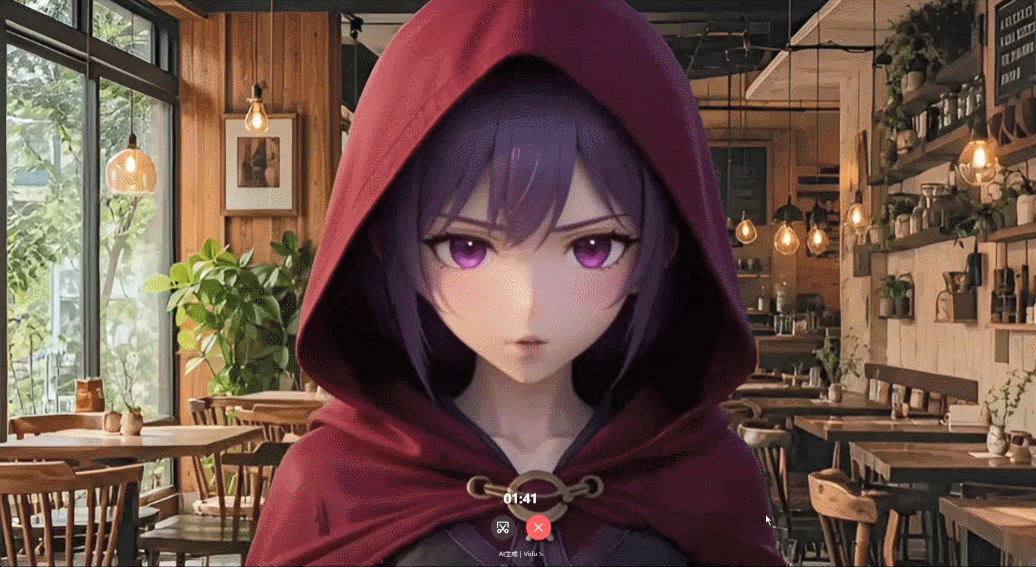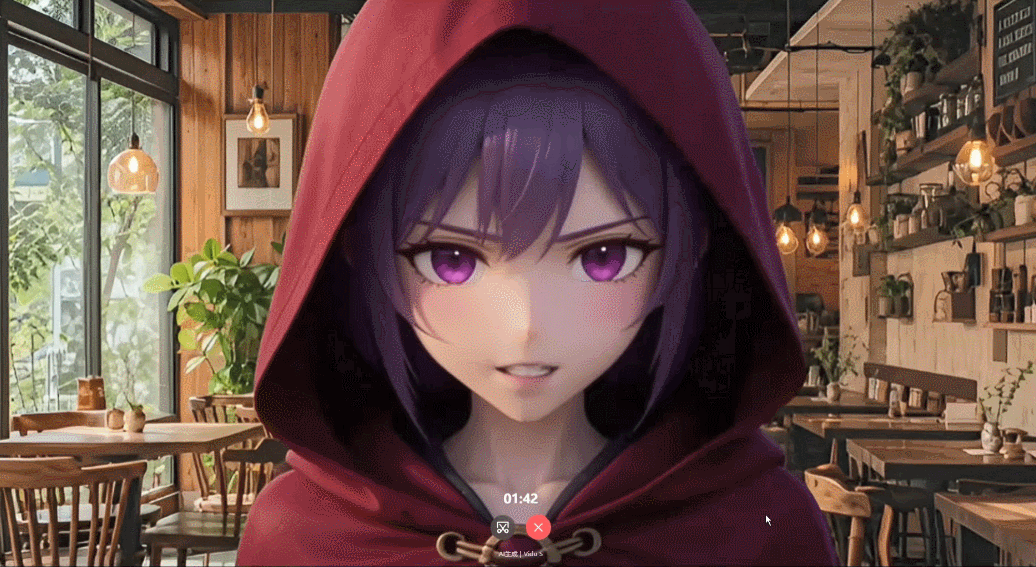
从夏天海滩走到星月宫殿,背景切换也十分丝滑,人物无损地从三次元进入仙侠世界,世界观原地重开,也能讲出更多故事线了。
在这次实时直播中,紫樱也无痕换了好几套衣服:性感黑裙、可爱睡衣、华丽古装、阳光网球裙......甚至黑裙还有不同款式,让主播和观众都过了一把奇迹暖暖的瘾。
此外,长时间直播,最怕错误越积越多。
实时视频是一段接一段生成的。上一段画面既是结果,也会成为下一段的参考。人物某一秒偏离了原来的长相,后面可能越走越远;一个动作出现问题,也可能继续影响随后的画面。
Vidu S2采用Self-Replay Forcing等训练方法,让模型在训练时反复面对自己此前生成的内容。简单理解,它不能一直拿标准答案当上文,而要看着自己已经写出的那一段继续往下写,并学习怎样把逐渐出现的误差拉回来。
放到一场持续几个小时的直播或者实时互动影游里,偶尔一帧失真,观众可能只会把它当成一次小故障;如果偏差被一帧帧传下去,角色的脸、发型甚至身体比例都会越播越陌生。
这次紫樱直播的高人气,除了源于人物IP本身,还有部分路人观众是被AI主播已经能够实时互动到如此精度、一直保持稳定输出所吸引。

当互动剧不用提前拍完所有选择
把紫樱放进直播间,是一次实时视频的产品测试。如果把同一套能力放进短剧和互动影游,问题会变得更有意思:观众还需要在制作方提前准备好的几个按钮里作选择吗?
此前,国产互动影游已经证明,观众愿意为“由我决定接下来发生什么”投入时间和金钱。
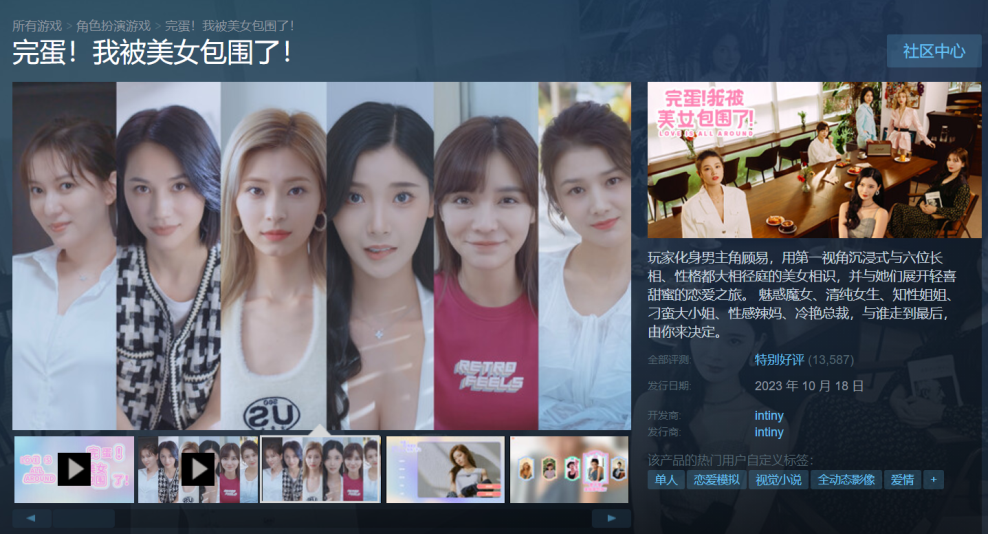
《完蛋!我被美女包围了!》采用第一人称视角,设计了百余种故事分支和12种结局;《飞越13号房》把选择放进悬疑逃生故事,设置了数百种分支走向和8个主要结局。
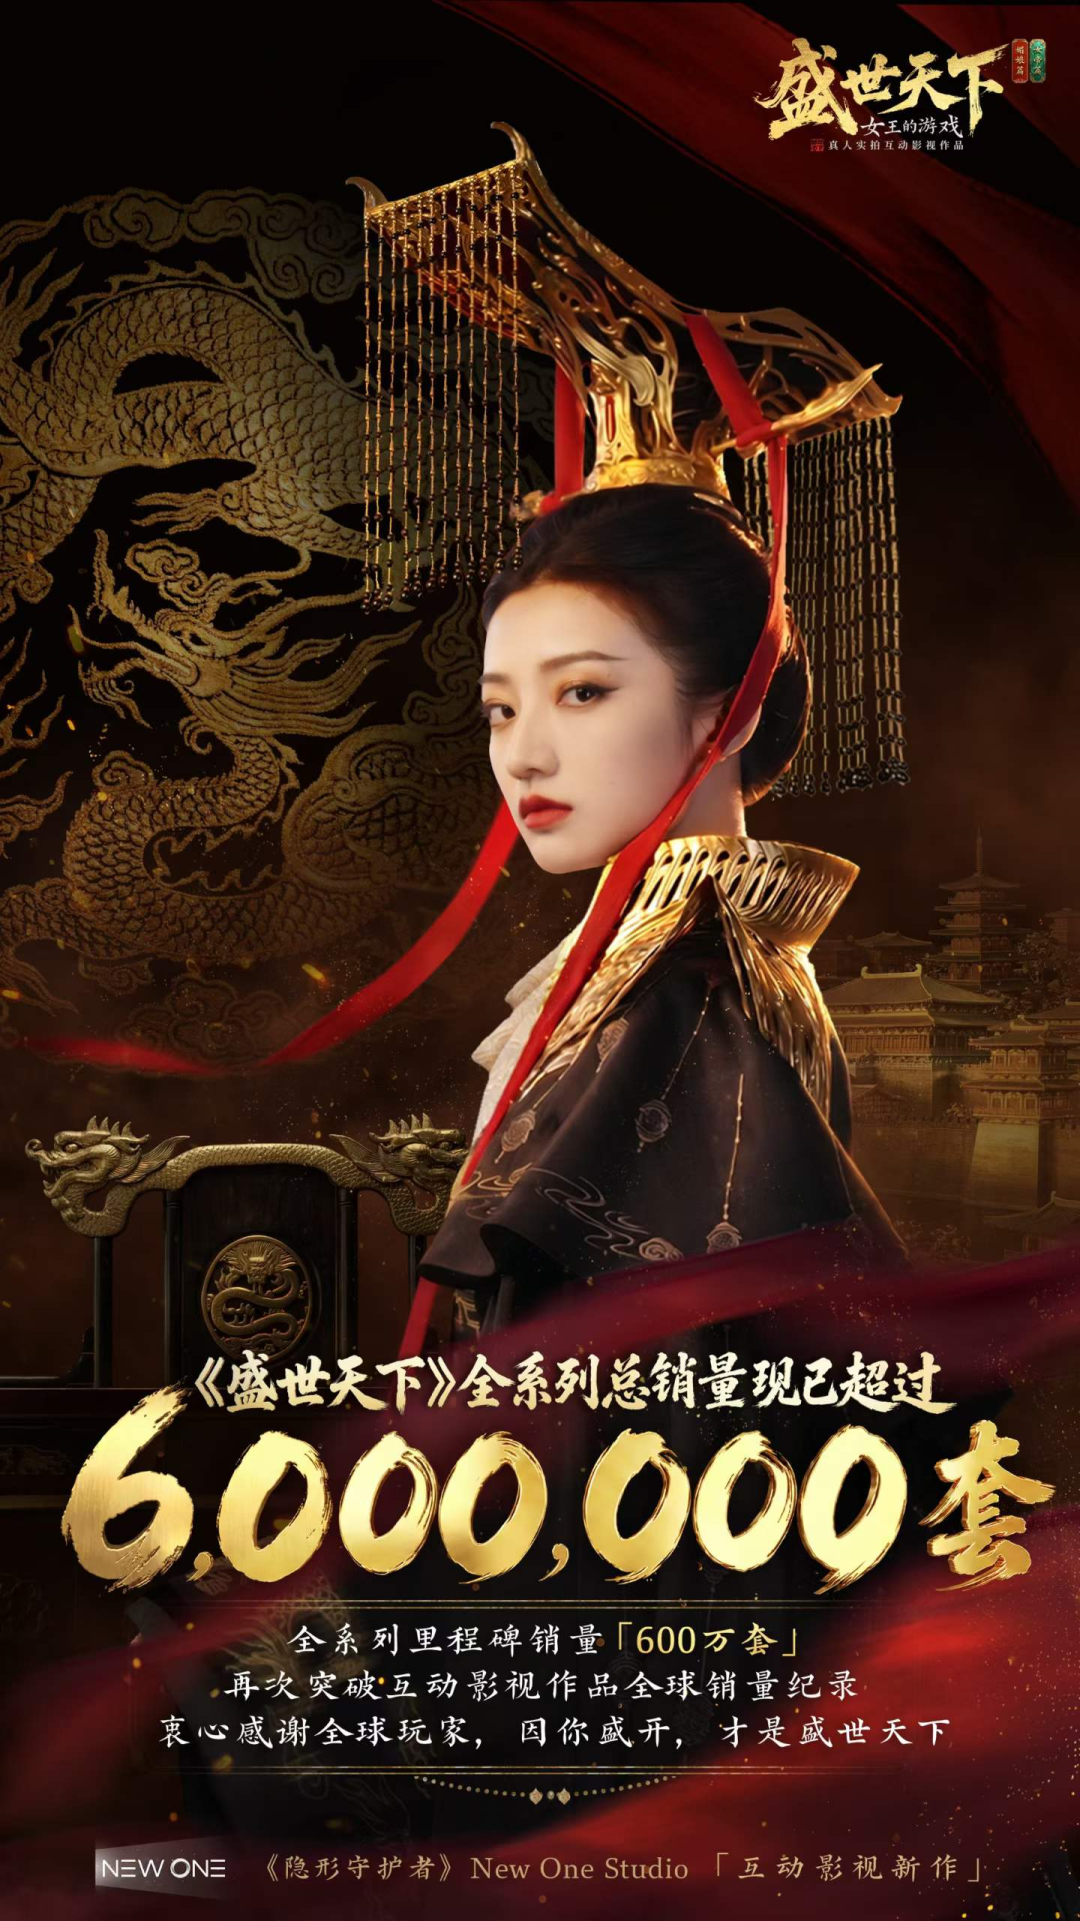
2025年走红的真人互动影游《盛世天下》,剧情素材总时长约1200分钟,包含400多个互动节点和百余个关键分支,支持玩家不断重开剧情。
今年8月,《盛世天下》女帝篇上线,21天后该系列销量突破500万套;9月系列累计销量突破600万套——足见市场空间。
这些作品提供了足够多的选择,只是选择依然发生在制作方提前拍好的范围里。每一个选项、每一种死亡方式和每一个结局,都要先写进剧本,找演员完成拍摄,再经过剪辑和后期。
制作方通常会让不同选项重新汇入同一条主线,或者让错误选择迅速通向死亡,以免整棵剧情树无限膨胀。
分支越多,素材量越大。但玩家最终只会看到其中一部分,不少支线拍完以后很少被触发。
实时生成提供了一种新的补充方式。创作者仍然提前确定人物、世界观和主要剧情节点,再把一部分局部反应留到观众作出选择以后生成。
不久前,Vidu与360达成深度技术合作,通过Vidu S2模型,助力360移动产品中心落地《甄嬛360传》粉丝见面会H5。
皇上、甄嬛等角色,不再是预设好的固定视频素材,而是可以随时唤起的交互对象,不局限于简单对话,还支持场景切换、道具生成、服装变化,甚至AI人物能够实时接上用户的话。
你上一秒还在宫殿里问皇上看佩剑,下一秒就可以邀请皇上去御花园散步,从宫殿到御花园,人物和不同环境光照都能自然适配、过渡。
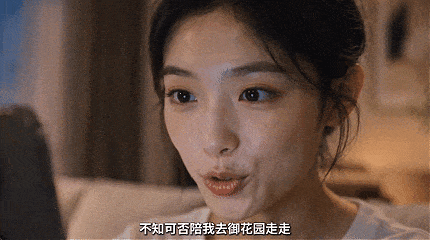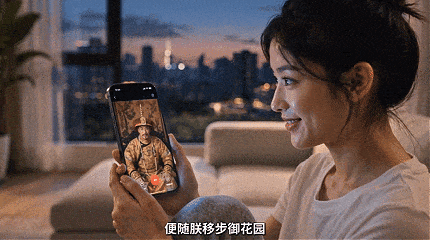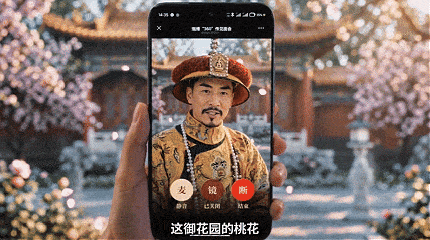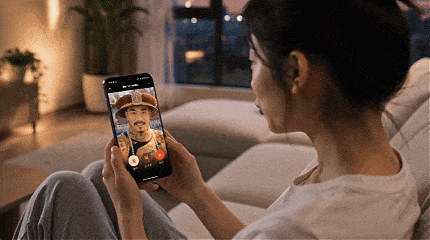
在这样的内容里,S2-Avatar能够临时改戏,让角色继续说话、完成新的动作,并在变化发生以后维持原来的人物形象。
S2-Editing处理的则是画面层面的调整:同一段表演可以更换服装、角色、背景和视觉风格,部分支线不用再为每一种画面变化重新拍摄。
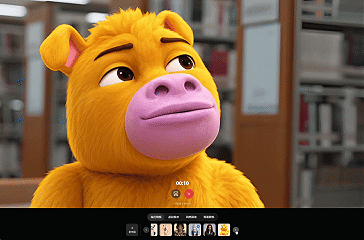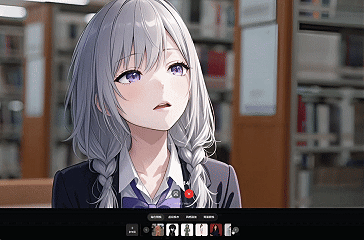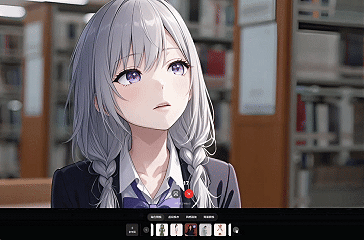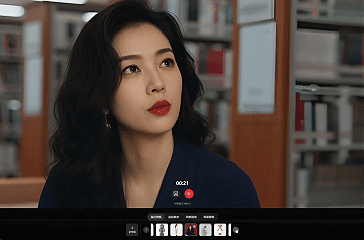
比如一部短剧演到女主被逼婚,观众可以决定她逃跑、反击,还是留下来套话。
选择逃跑以后,角色需要立即转身、推门或者避开追赶,S2-Avatar可以让角色快速接戏;如果剧情要求她换上男装混入夜市,衣服和场景也要跟着改变,S2-Editing便可以派上用场,在保持角色一致性的同时根据剧情需要改变画面。
综合来看,长剧情仍需要创作者提前设计,人物关系、主要冲突和结局范围不能全交给临场生成。实时模型则可以先处理一场戏里的临时动作、短对话和小范围分支,让一些过去必须提前拍好的反应,可以等观众作出选择后再出现。
这与短剧现有的生产习惯并不相悖。短剧团队本来就会观察评论、转发和网络梗,再调整后续故事。实时视频可以把等待时间继续压短,让部分反馈在当场进入表演。
互动影游也可能因此摆脱一部分预设按钮。
当实时视频模型与对话、角色和剧情系统结合,玩家可以自己组织问题审问嫌疑人,在遭遇追捕时临时提出行动方案,也可以用不同语气说服、威胁或者欺骗一个角色。第二次回到同一个剧情节点,换一种问法或身份,对方的反应便可能随之改变。
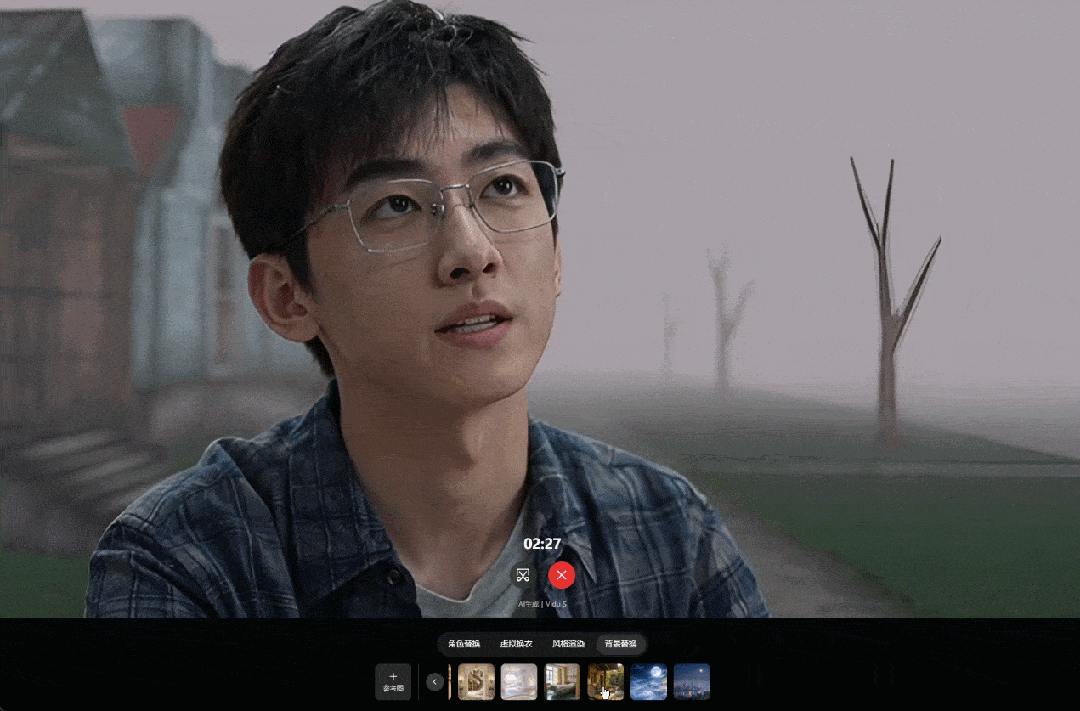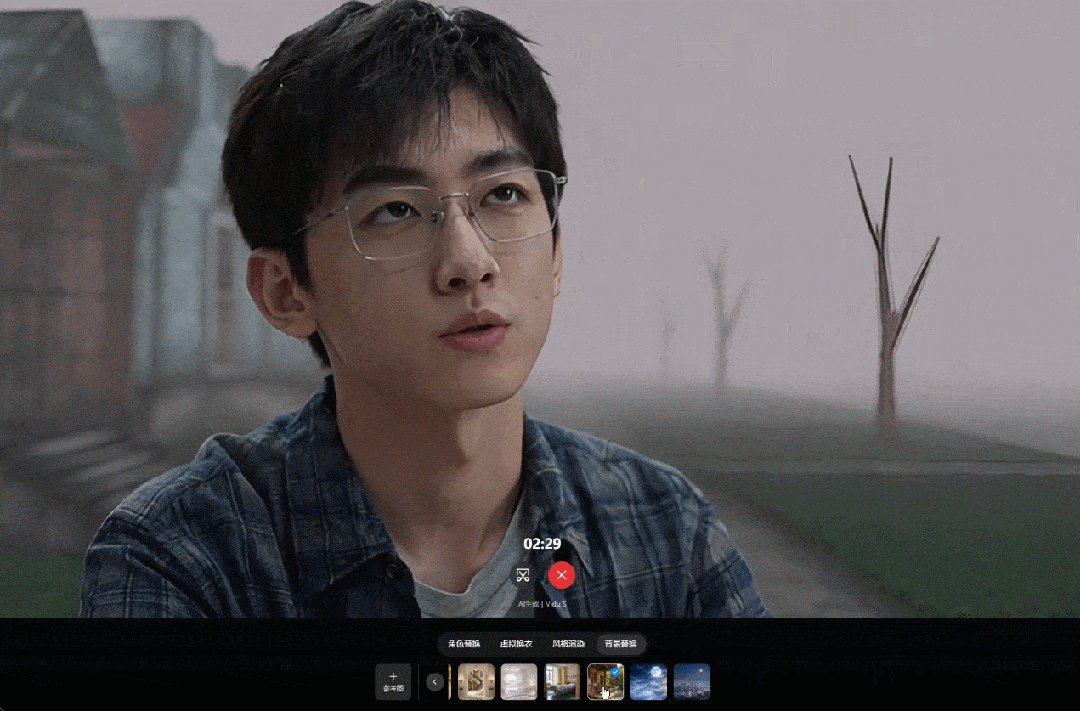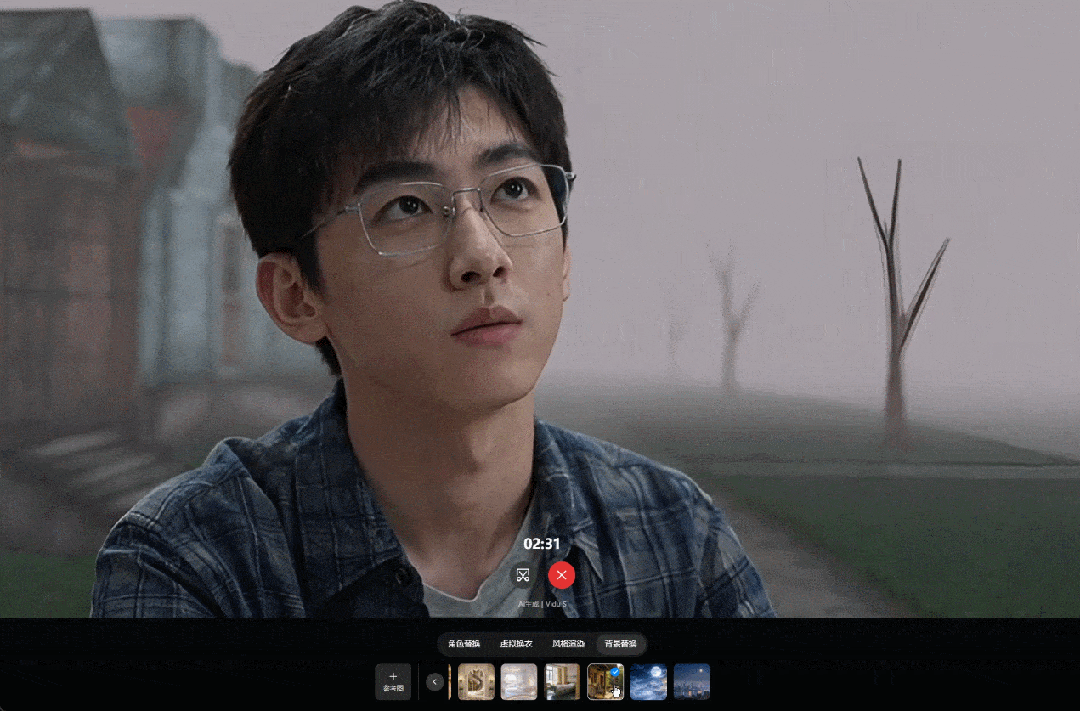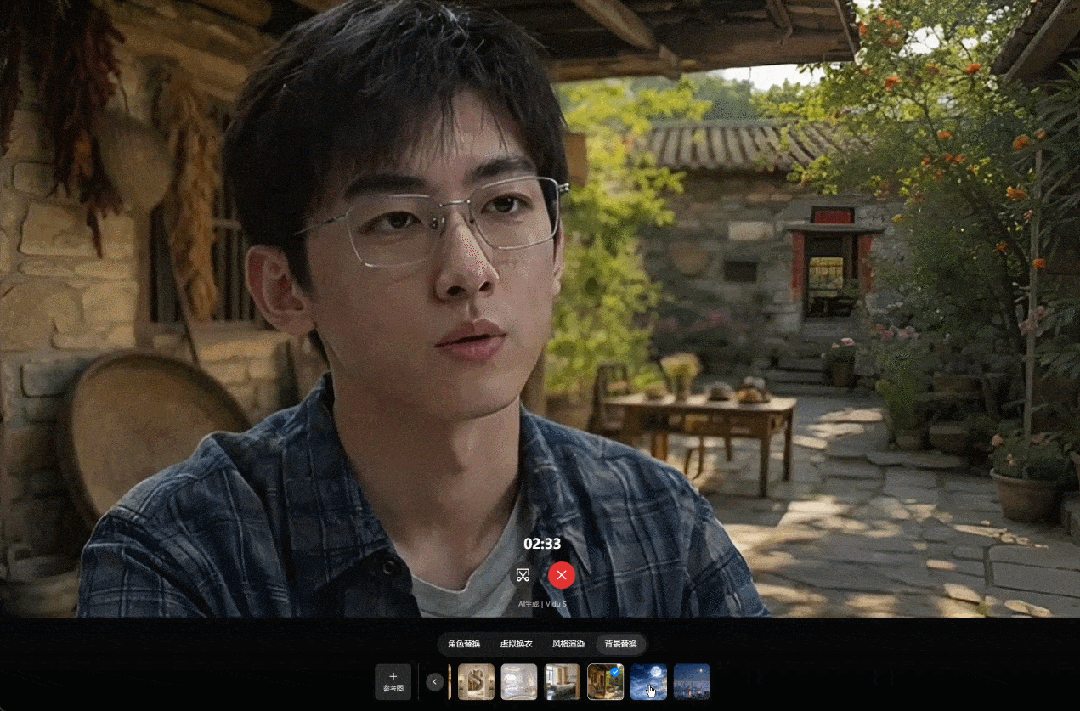
我们认为,实时视频模型在短期内更现实的应用形态,大概是一条固定主线加上一些实时生成的局部分支。创作者决定人物关系、冲突和结局范围,模型负责处理临时对话、动作、小场景以及玩家没有按标准选项行动的时刻。
这样既能保住故事的完整度,也能让观众感觉自己的输入真正进入了剧情。
紫樱的直播,已经像一次缩小版的角色测试。
直播开始前,团队可以确定紫樱的形象、性格和基本玩法,却无法提前知道观众会说什么、送来哪件礼物。观众喜欢她怎样回应、愿意为哪套衣服送礼、看到什么反应会继续停留,这些结果都来自角色与真实观众的相处。
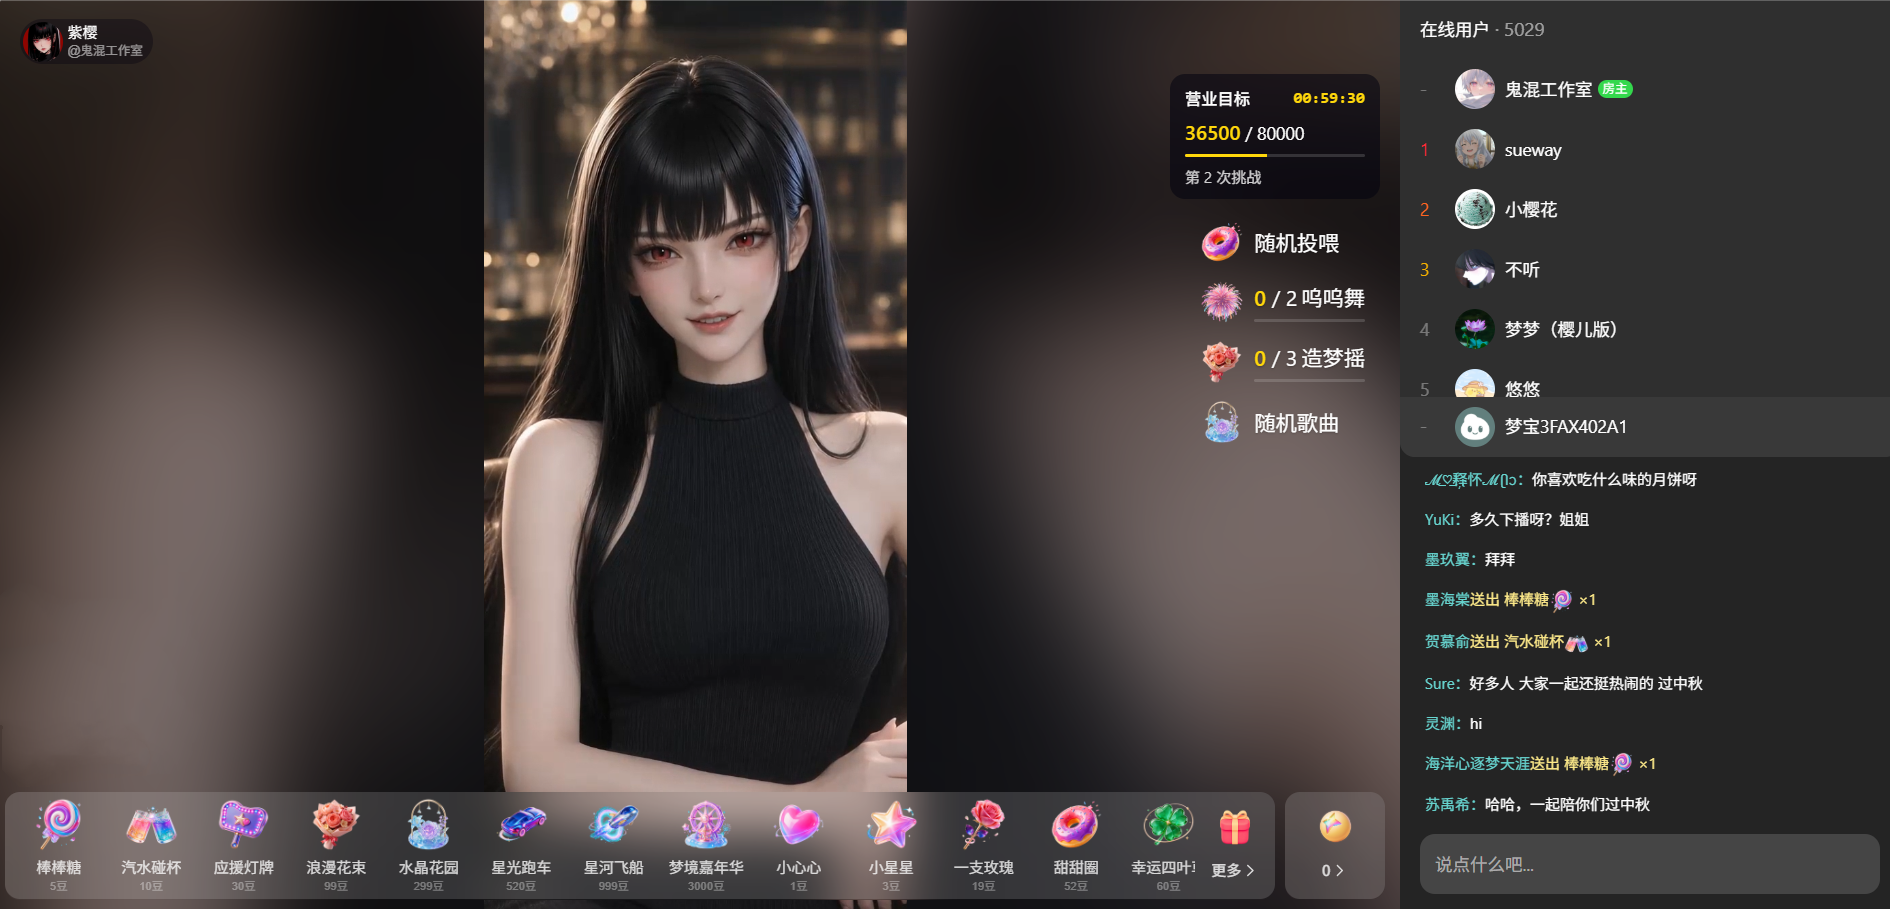
挑战结束前,很多粉丝在弹幕里表达了不舍,不希望紫樱就此“下班”。因此团队临时决定加更三天,从28日开始挑战成功后的限时返场,延续中秋节的这场活动,紫樱会继续和观众实时互动,点歌、换装、随机穿越等玩法也照常开放。
同样的方式也可以用在短剧开拍之前。一个新角色、一组人物关系或者一套世界观,先进入直播间营业几小时。大家愿不愿意留下,喜欢她和谁聊天,会不会为某种性格或某对CP送礼,都能成为后续开发的参考。
当然,这距离一部完全实时生成的短剧或互动电影还有一段路。人物能否在几个小时里保持一致,临时生成的剧情能否接回主线,AI表演能否撑住细腻的情感戏,都会影响这种内容最终能走多远。
在Vidu S2这类实时视频模型的支持下,互动影视的想象空间已经被往前推了一步,
过去,互动剧让观众在已经拍好的故事里选路。下一步,故事或许会在观众作出选择以后,才开始铺出后面的路。


