逐帧解密“顶流”AI短片《Candy》!DiDi_OK超详细教程来了!
发布日期:2026年10月10日
最近AI视频圈有一部很难绕开的片子,就是DiDi_OK的AI科幻短片《Candy》。截至发稿前,上线不到一个月的《Candy》已在B站斩获超500万播放量,登顶B站热搜。在海外社媒平台X上,其相关内容单条曝光也接近百万,热度暴增。(图为:截至发稿前,《Candy》在B站上的播放量)几乎所有人在看完这部片子后的最大感受,都可以用四个字总结:惊为天人。同样是人类,为什么他他他他就能用Seedance 2.5做出这样的片子???9月16日,DiDi_OK在直播里详细拆解了他的制作流程,对其完整工作流和核心提示词进行了开源。短剧自习室在看完了接近两个小时的直播后,我只能说,他太强了,真的。以下是我们对DiDi_OK的《Candy》制作教程实录整理(实录梳理自火山引擎对话DiDi_OK直播间):
前期调研:在Figma上理清作品的核心表达
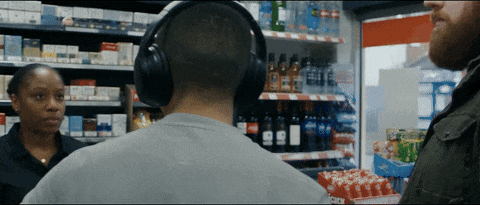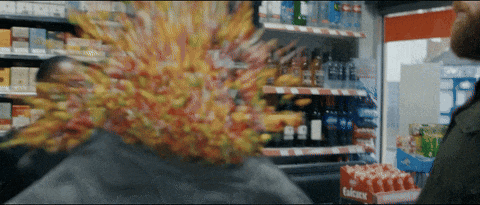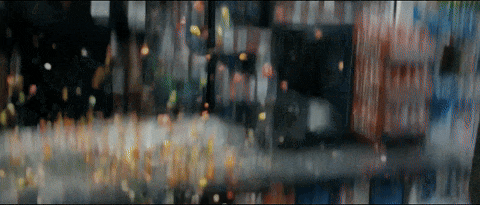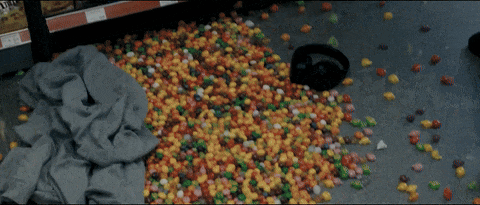
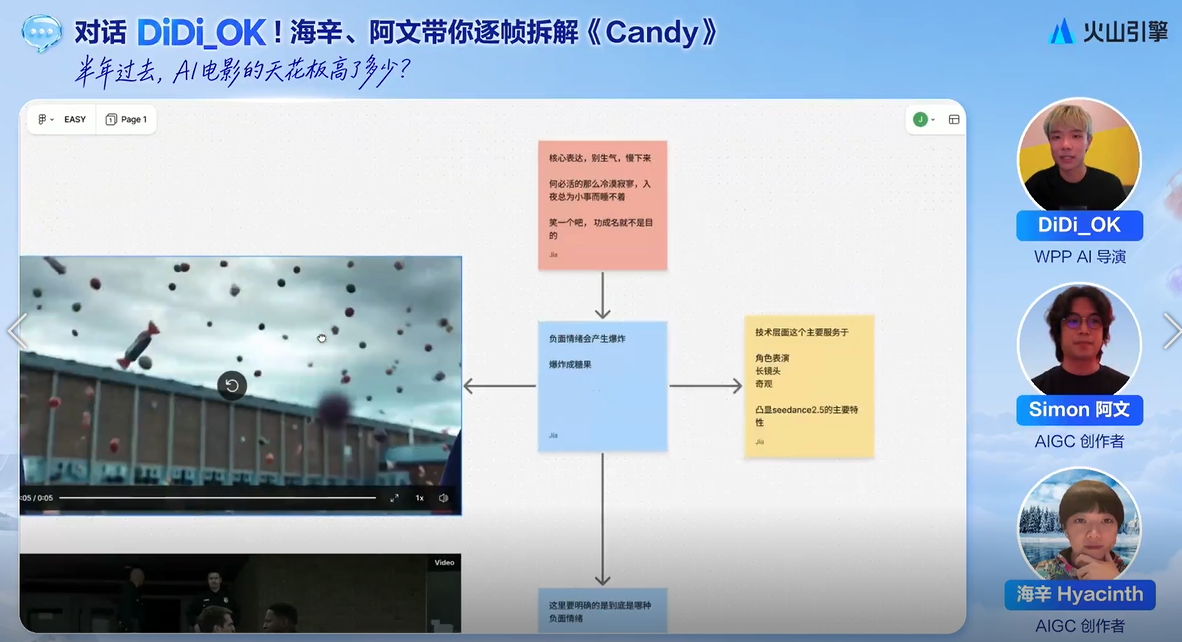
一切的一切,要从创作者的表达欲开始。说白了,它也是你片子的主旨。DiDi_OK写下了《Candy》这部片子的核心表达内容:别生气,慢下来。对于创作者想要表达的内容和想要呈现的画面效果,进行技术测试。在不同的景别、灯光效果下,DiDi_OK分别对「人能不能爆炸成糖果」,进行了AI生成视频的技术测试,并发现人物身上穿着的衣服,能留在地上。也就意味着,因为负面情绪而产生爆炸的,只有「人」——技术可以满足表达。《Candy》在技术测试中,明确了「人会因为负面情绪而爆炸成糖果」的内容表达后,到这一步就要明确其所设立的是哪一种负面情绪?同时,需要注意这种负面情绪具有普适性和延展性。这种负面情绪,他认为是:生气。所以,他得出了作品的核心画面思路:「人会因为生气而爆炸成糖果」。并且,生气不是无缘无故的生气,而是气别人,别人会炸,自己也会炸。与人为难,自己为难。站在观众的角度回看,你所要制作的内容能否被大众接受,会不会因为极端情况引发观众不适,还是说可以通过叙事让大家意识到这是设定的「黑色幽默」。
中期开展:在Figma上构建故事小传
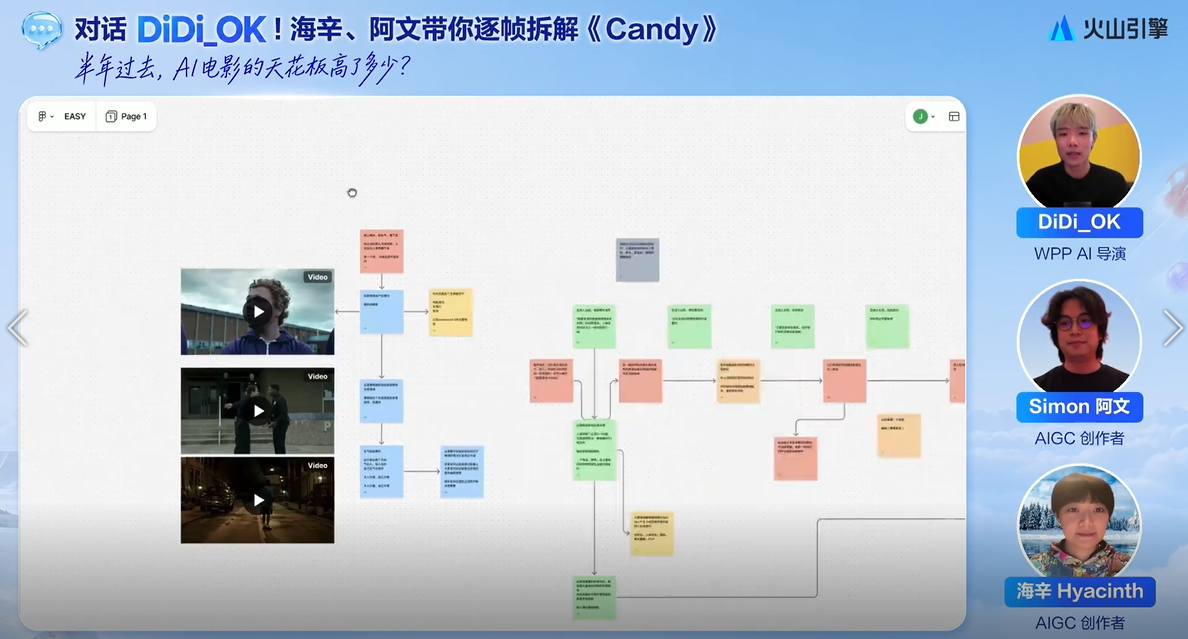
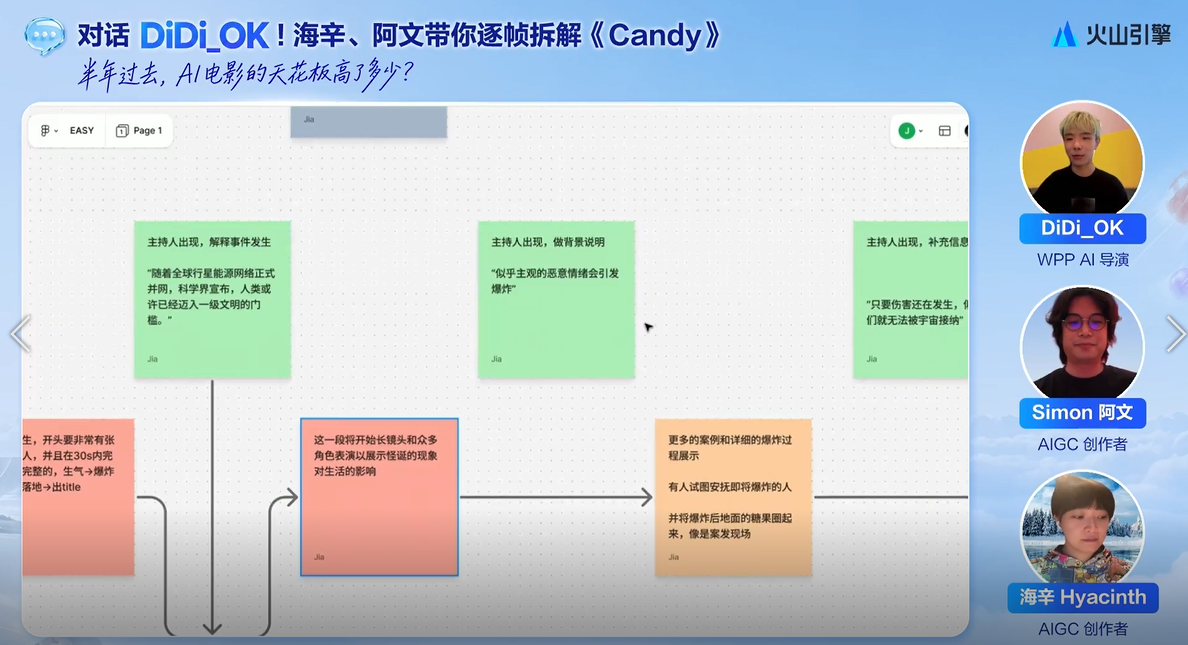
DiDi_OK介绍,自己虽然不做分镜,但会设立一个又一个的故事节点。
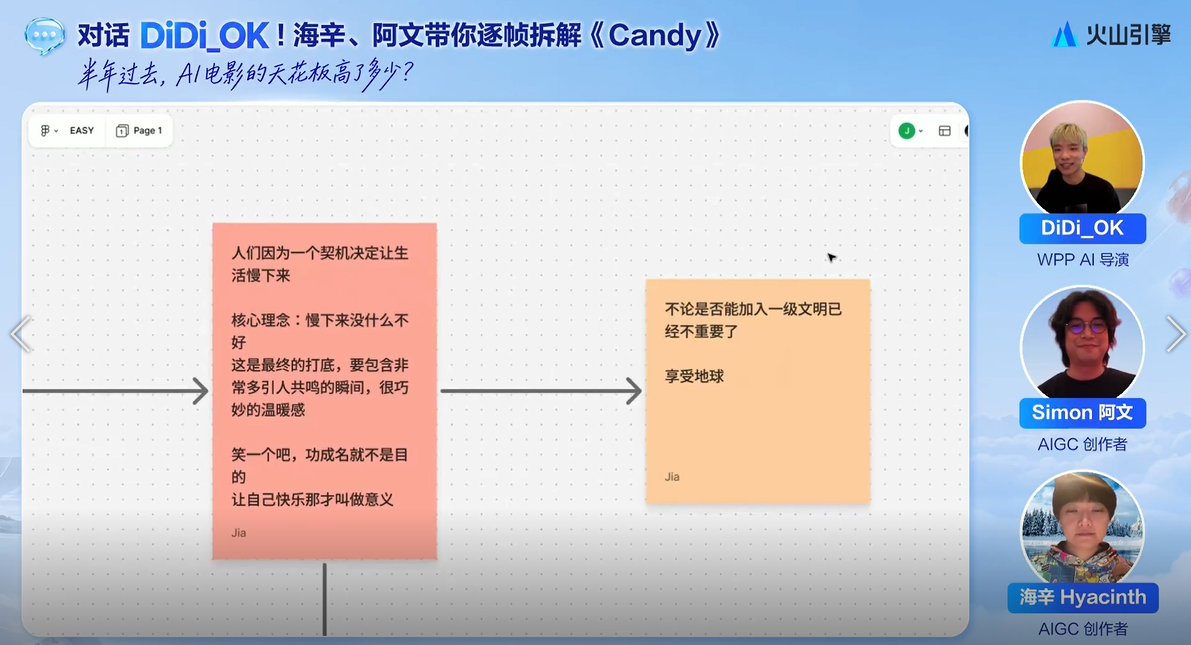
开头要非常有张力,抓人,并且在30秒内完成一次完整的,生气→爆炸→糖果落地→出title。(但DiDi_OK解释,这一步写了但是没用上。)比如,设计主持人出现,解释事情发生。这一步,其实是在告诉观众,事情发生的背景,是有因有果的,而不是创作者自嗨。在背景设定中需要注意,对应生成的画面是否能够完成,观众是否能够比较好接受。同时,确定故事动机,是怎么发生推进的。像《Candy》中,因为发生了大量角色爆炸,所以还需要注意规避一些伦理困境,最终就设定为爆炸并非作者导致,而是宇宙机制。爆炸的人,有爆炸的合理性,比如有人对他人产生主观恶意并想伤害他人时就会发生爆炸,这种情况包括人身攻击、骚扰、PUA等。比如,《Candy》中的主持人,他的作用就是照顾观众的观看节奏。他需要解释事情发生,做出背景说明,对信息进行补充,确定时间线。这一步就是在提前思考要补充哪些信息,相当于不断叠加故事的背景设定。比如,《Candy》需要用到更多的案例和详细的爆炸过程展示。(这一个思路,DiDi_OK实际上也没有在影片里呈现。)紧接着,在影片中,人们开始研究这种「人会爆炸成糖果」的现象并证实了原理。同时,DiDi_OK还在这里反推了一下这里需不需要契机,比如糖纸?糖果本身?DiDi_OK试图在《Candy》中,引申到最后的「他人即地狱」的母题讨论上,但由于这样子做,可能会让影片陷入负面表达,所以被放弃了。基于这样的想法,《Candy》想要表达的内容最终定下来,被引申到了让生活慢下来、大家一起「享受地球」。
后期制作:逐步搭建视觉素材库
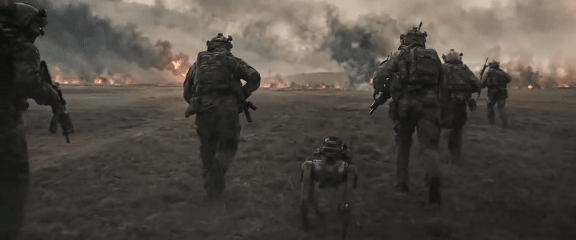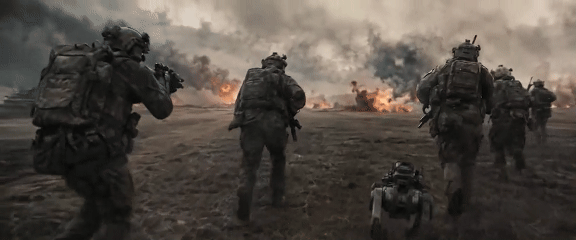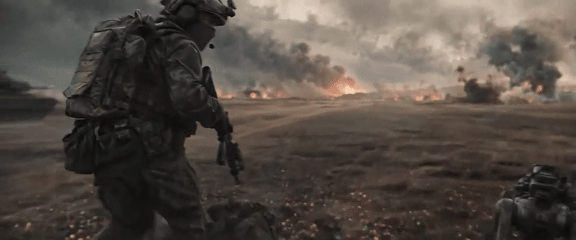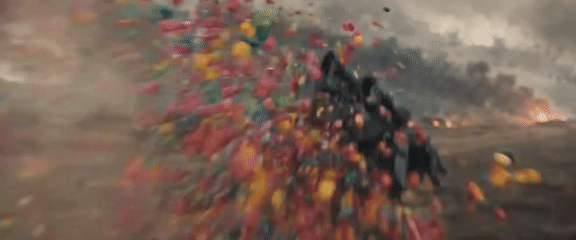
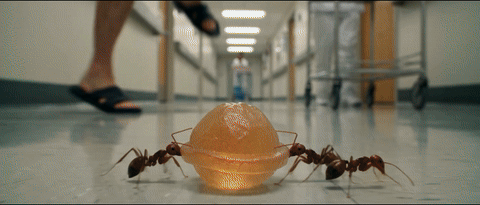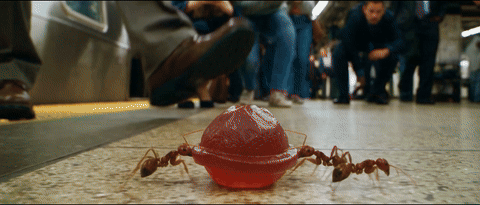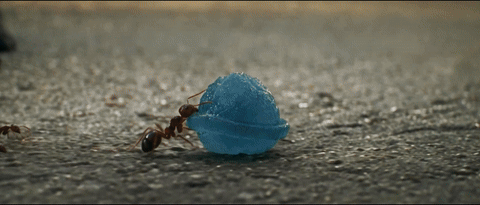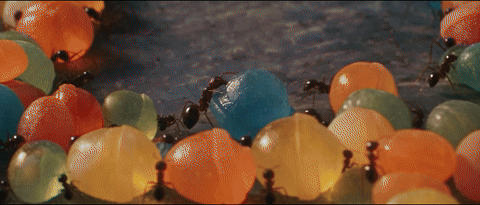
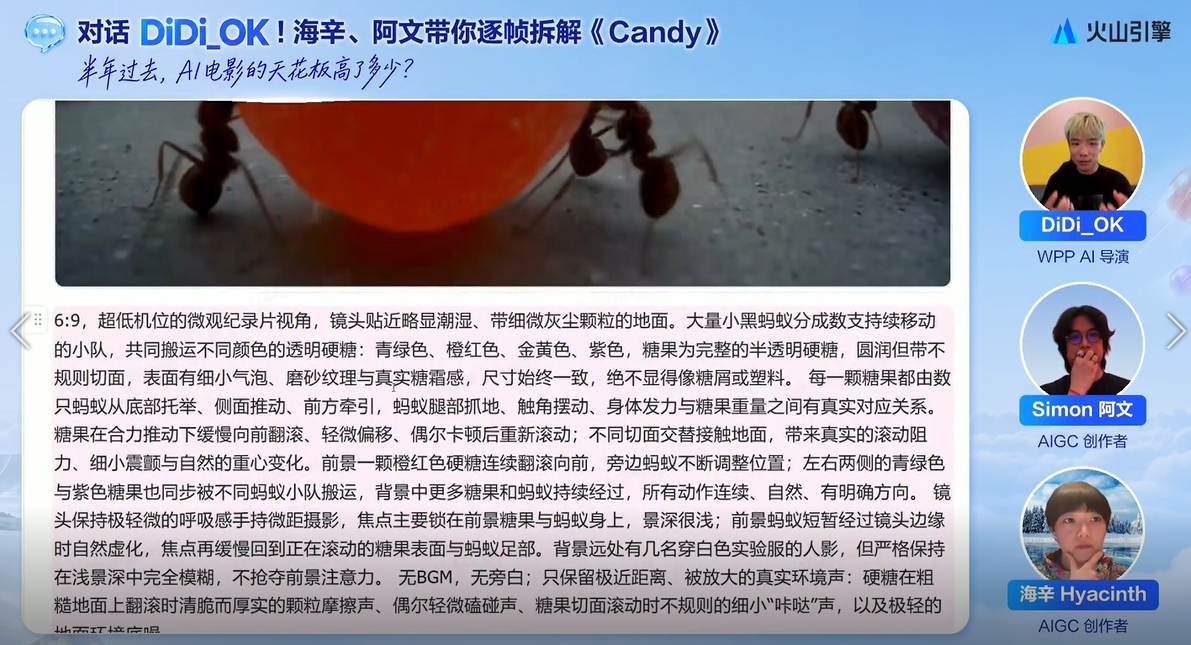
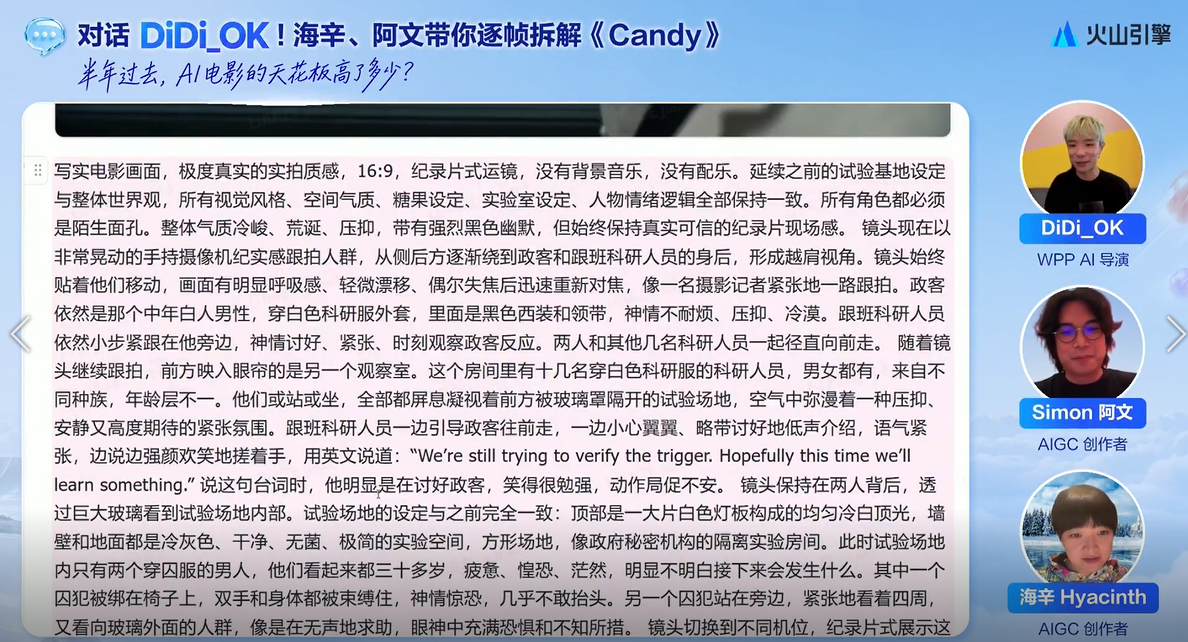
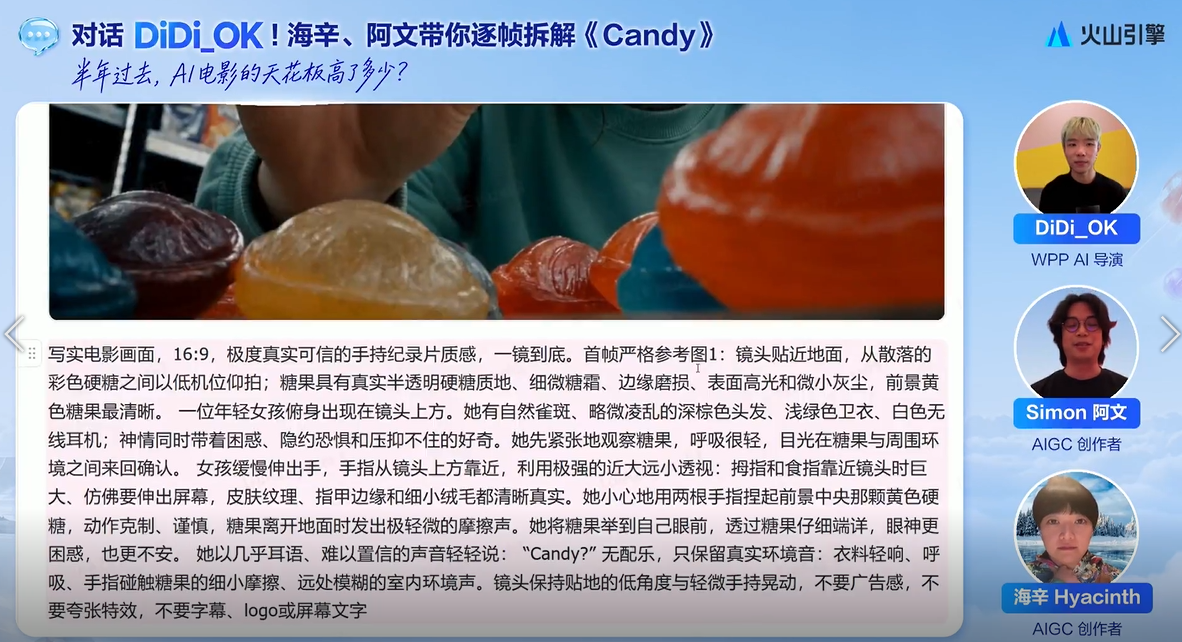
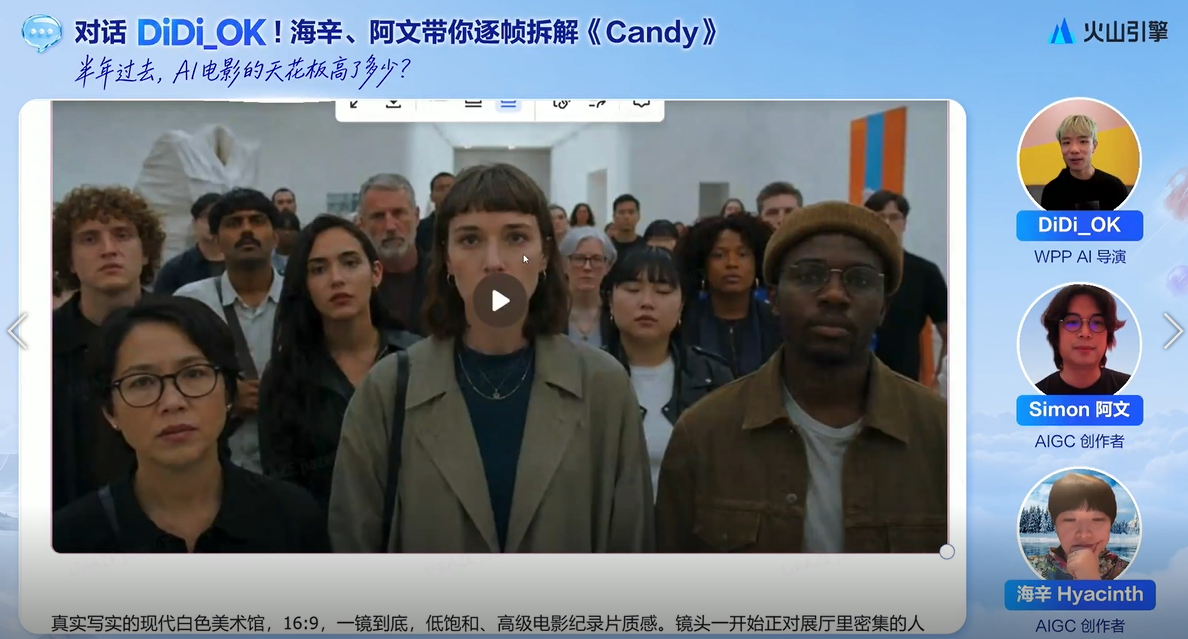
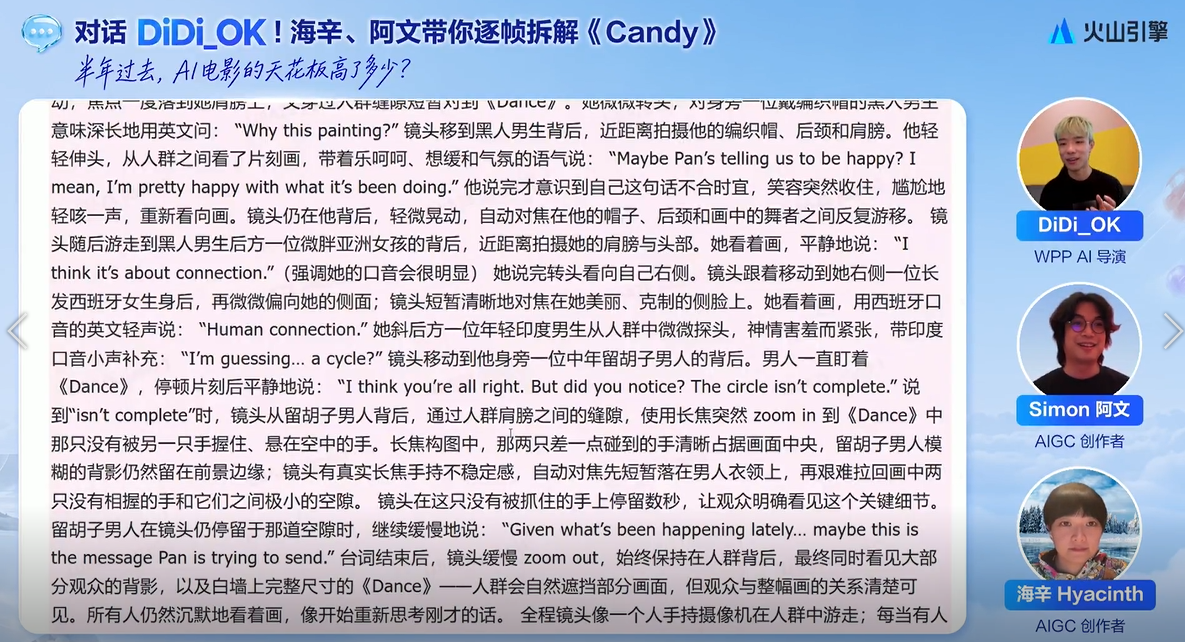
比如,《Candy》中的糖果应该长什么样?糖果的材质应该是什么?最后DiDi_OK把这一道具设定为和真实世界的糖果越接近越好。在《Candy》中,就是整个片子必须围绕欢乐的黑色幽默。根据想要表达的内容制作一些镜头,这些镜头中,也会出现一些「废片」。即使是DiDi_OK,也并不是一次完成,而是经过多次提示词迭代和抽卡的。DiDi_OK分享,其在提示词创作中,基本靠手搓,用提示词非常详细地描述每一个角色,他们是怎么运动的?他们的目的是什么?如果生成的效果不对,再去改。知道自己哪一句提示词对应哪一个效果非常重要。如果用AI写提示词,那么在关键镜头的表现上,就有可能出现,发生问题了,但不知道哪里有问题。并且用AI写的提示词会因为过于「完美」,而没有鲜活感,没有「人味」。提示词的作用,就是帮助AI理解视觉锚点。在使用Seedance 2.5的过程中中,DiDi_OK认为提示词的权重比参考图重要。比如,在镜头拆解环节,他透露,《Candy》的一个战争镜头中,仅用了一张参考图,其余全部依赖提示词。同时,他还分享了一个个人制作的小技巧(重要知识点):用视频生图。特别是遇上需要做空间镜头的场景,比如上面讲到的战场,就可以直接用视频让AI去跑图,让AI找到正确的空间关系和机位,AI相当于起到了一个「记者采风」的作用。在设计「人物表演」镜头时,DiDi_OK分享到,自己会在家演一下,然后把自己的感受写到提示词里,如此才能让AI的表演有更丰富细腻的「人味」,更真实。比如他告诉模型:这个人是一个讨好型的状态,他是有自己的目的的,并且这种讨好是有一点小油腻的,让人不喜欢的。说白了,就是让AI更好地去理解表演。设计「动画」镜头时,DiDi_OK也是采用纯AI生成,3D动画的运动规律表现等都有不错的效果。比如在Seedance 2.5上通过首尾帧参考,直接生成移轴动画,效果有所提升。《Candy》中的「蚂蚁推糖果」画面,也是完全依赖AI,用提示词一遍生成。为了实现在这个16秒的视频中不断地切换场景,DiDi_OK说,写了4000字提示词。果然,一个好的AI生成镜头,背后的提示词不亚于一篇小作文。《Candy》中的下面这个「转场」放在以前是需要扣绿幕加上AE软件编辑的,但现在全靠提示词,并且这个镜头看起来是一气呵成,但实际上,DiDi_OK也是分段来做的。在做「群像」的长镜头时,DiDi_OK则利用上了Seedance 2.5的一个新功能:30秒的长镜头。其中出现的大量演员调度,都是DiDi_OK通过提示词实现的。这个镜头,最终一遍完成。同时,为了给观众营造出一种类似趴在人物肩膀上观看的「临场感」,他还让AI参考了手持摄像机的感觉,营造细腻的抖动感。最后,DiDi_OK建议,生成镜头的提示词中尽量强调“无BGM”,如果AI给到的版本还是有的话,可以通过平台筛选或者后期剪辑工具分离。坚持画面优先原则。DiDi_OK的做法是留下最完美的画面,然后用画面作为参考图,再去生成声音,直到生成满意的、喜欢的声音合成就好。
敲黑板:DiDi_OK的提示词怎么写的?
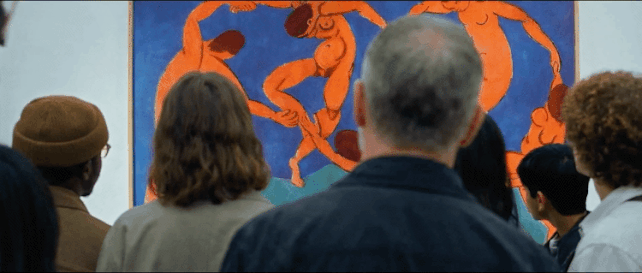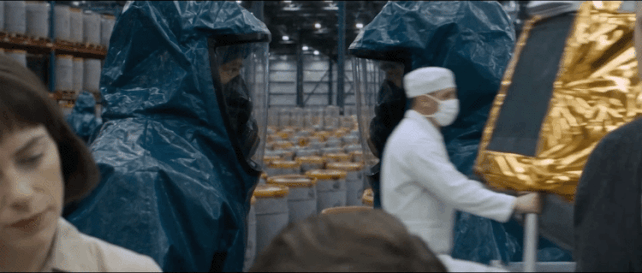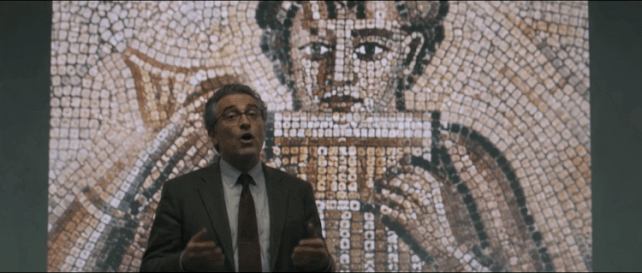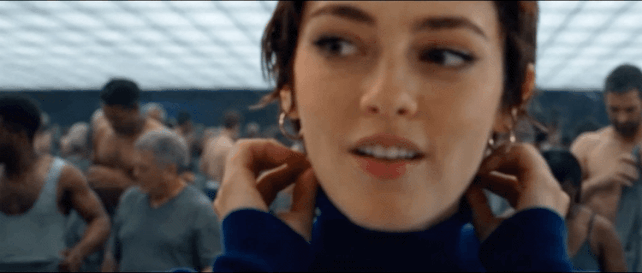
在DiDi_OK制作过程中,他主要通过提示词来调用Seedance 2.5的能力。而大家最关心的问题,DiDi_OK到底是怎么写提示词的?怎么驯服AI的?第一,在写提示词时,需要把自己完全代入场景,就好像你站在它的面前一样。比如这颗糖果的质感,上面会有细小气泡、磨砂纹理和真实糖霜感,它滚动起来时,发出的声音,应该是咔哒咔哒的……提示词尽可能自己写的原因上面也提到了,如果画面出现了问题,可以知道问题出在哪一句提示词上。就连DiDi_OK也避免不了,遇上AI生成的画面是一个女孩真的在旁边喊:咔哒咔哒。显然,这里就是咔哒咔哒这句提示词的权重出现了问题,调整后迭代就可以了。提示词需要尽可能写得细,也能拉进和观众之间的距离,省掉很多叙事成本。第二,就是前文所提到的,DiDi_OK在写人物相关的提示词时,会把状态和感受写出来。这样才能让AI「演」出细节。必要时,他会自己先演一遍。还值得一提的是,提示词不用太高深,口语化的风格也是完全OK的。在给「女发言人」写提示词,他用上了参考图。因为有些东西是提示词说不清的。但有了参考图后,提示词也可以在参考图的基础上,夯实一些东西,比如,LED屏幕的摩尔纹是怎么样的摩尔纹。在小女孩拿糖果这个画面时,DiDi_OK就用到了「首尾帧」功能。第五,巧用Seedance 2.5的长视频功能+参考图,给AI理解世界的空间。比如,在这个「女生看画」的镜头中,DiDi_OK让Seedance 2.5生成一个长视频从正面绕过。并且,他要求,在绕的过程中,Seedance 2.5已经把空间里的角色和位置关系自己理解了一遍。然后你就可以在生成的长视频中,截取自己想要的片段。梳理完DiDi_OK的创作流程,短剧自习室必须小声BB一句:不得不说,大佬的“邪修”教程还是太顶了!所以,你get了多少小妙招呢?谁又会成为下一个“大佬”?期待ing!
<